AI Agentic RAG高级企业知识库平台
项目简介:基于企业知识库、PGVector 向量检索、Agentic RAG、FastAPI + LangGraph、Function Calling,实现向量 + BM25 混合检索与 RRF 融合、Rerank 重排、HyDE 与多查询改写、父子分块召回、LangGraph 状态图自适应检索、Agent 执行时间线和 LLM-as-judge 四指标评测,覆盖从基础 RAG 到高级 RAG 调优的完整闭环。
本项目覆盖的技术点
学完能答的面试题
学完这个项目,下面 51 道面试题你都能结合项目细节讲出来。题目在 AIGC 面试刷题网可以免费看。
系统架构
一张图看清整个系统的分层与核心链路,点开可缩放查看细节。
- 1接入层:用户端 + 管理端Vue3 双端共用一套 FastAPI 接口,PyJWT 鉴权、统一返回与全局异常、sse-starlette 流式输出、Tortoise ORM 异步访问数据库。
- 2文档入库链路(离线)上传 → 复杂文档解析(PDF 表格、扫描件 OCR)→ 递归 / 父子分块 → 人工修正片段 →
text-embedding-v4向量化,PGVector 只存子块向量、父块 ID 和元数据。 - 3检索链路(在线)查询改写 → 向量 + BM25 两路召回 → RRF 按名次融合 →
gte-rerank-v2重排 → 父块回填与按量纲阈值过滤,开关与阈值都在页面上配置。 - 4Agentic RAG 状态图LangGraph 编排改写、检索、相关性评分、生成、幻觉校验;资料不相关就换说法再检索,答案没出处就重写,到上限明确拒答,每一步落
agent_step可回放。 - 5存储、模型与质量底座MySQL 25 张业务表 + PGVector 向量表;三类模型走阿里云百炼、管理端配置即时生效;LLM-as-judge 四指标评测量化每一次优化。
技术栈
用到的框架、中间件和模型。
技术难点与解法
每一项优化都针对一个真实问题,讲清楚问题、做法和背后的原理。
01专有名词检索不到
- 问题
- 问「
GTE-3000的保修期」,向量检索找不到写着「型号GTE3000质保时长」的段落。 - 做法
- 向量 + BM25 两路一起召回,再用 RRF 按名次融合;中文分词额外把
GTE3000拆出gte和3000。 - 原理
- 向量认同义词但认不出精确型号,BM25 正好相反。两者分数量纲不同不能直接相加,RRF 只看名次。
02答案召回了却排在后面
- 问题
- 写着答案的片段排在第 4 位,前三段看着相关其实没回答问题,模型被带偏、答非所问。
- 做法
- 粗筛之后加一层重排;百炼重排接口不走 OpenAI 兼容模式,自己封装成 LangChain 的
BaseDocumentCompressor接进检索链路。 - 原理
- 向量检索是双塔模型,只能判断「整体像不像」;重排把问题和片段拼在一起做交叉编码,准但慢,只适合用在粗筛之后。
03一个阈值把结果整片砍掉
- 问题
score字段在管线里被反复覆盖:余弦、BM25、RRF、重排四种量纲取值范围差一个数量级,用同一个阈值去卡会把结果全砍掉。- 做法
- 量纲作为显式信息跟着结果一路传下去,策略里给余弦相似度和重排分各配一个阈值,RRF 名次分不做阈值过滤。
- 原理
- 阈值只有在同一量纲下才有意义;RRF 分只表示名次先后,页面上明确标注「本次不适用」。
04找得准和答得全互相矛盾
- 问题
- 片段小则命中准但上下文不全,片段大则上下文完整但一段混多个主题、难命中。
- 做法
- 切两遍:只把子块向量化参与检索,命中后回填整个父块给模型生成,配合元数据过滤收窄范围。
- 原理
- 小块用来找,大块用来答,把「检索粒度」和「生成粒度」拆开。
05检索几轮该由谁决定
- 问题
- 固定流程写死「检索一次就生成」,召回不相关时只能硬答;可要是让模型自己决定,过程又像黑盒。
- 做法
- 用 LangGraph 把「检索 → 评估 → 改写 → 再检索 → 生成 → 自查」编成状态图,每一步写入
agent_step,前端用时间线回放。 - 原理
- 检索几轮、改写几次由模型每一轮的判断决定,代码只设循环上限,这是 Agentic RAG 与固定编排的本质区别。
06优化效果怎么证明
- 问题
- 调了一堆检索参数,只能凭感觉说「好像变好了」,没法判断该调检索还是调 Prompt。
- 做法
- 实现 LLM-as-judge 四指标,评测用例标到来源片段,Context Recall 直接做集合运算;多份报告在看板上并排对比。
- 原理
- 四个指标把 RAG 拆成「找资料」和「写答案」两段各测两项;裁判模型 temperature 必须为 0,否则分不清是策略变了还是裁判抖了。
功能清单
按角色看这个系统都能做什么。
知识库管理7 项
- 知识库管理企业资料的一级分类,绑定向量模型与切分策略
- 切分策略维护递归分块与父子分块两类策略及其参数
- 检索策略七个检索开关:向量、BM25、RRF、重排、查询改写、父块回填、两档阈值
AI 配置6 项
- AI 模型配置三类模型的接入配置与连通性测试
- Prompt 模板所有发给模型的提示词在页面维护,改完立刻生效
- 工具中心登记 Agent 可调用的工具,启用开关是真开关
问答应用3 项
- 应用管理配置问答应用绑定的知识库、检索策略与回答 Prompt
- 问答测试管理端直接测试问答效果
- 对话日志与反馈查看完整对话记录,用户点踩的问题进入优化清单
效果评测3 项
- 评测集管理手工录入、从文档自动生成、从点踩沉淀三种方式维护用例
- 批量评测选定评测集与检索策略跑一轮,LLM-as-judge 给出四项指标
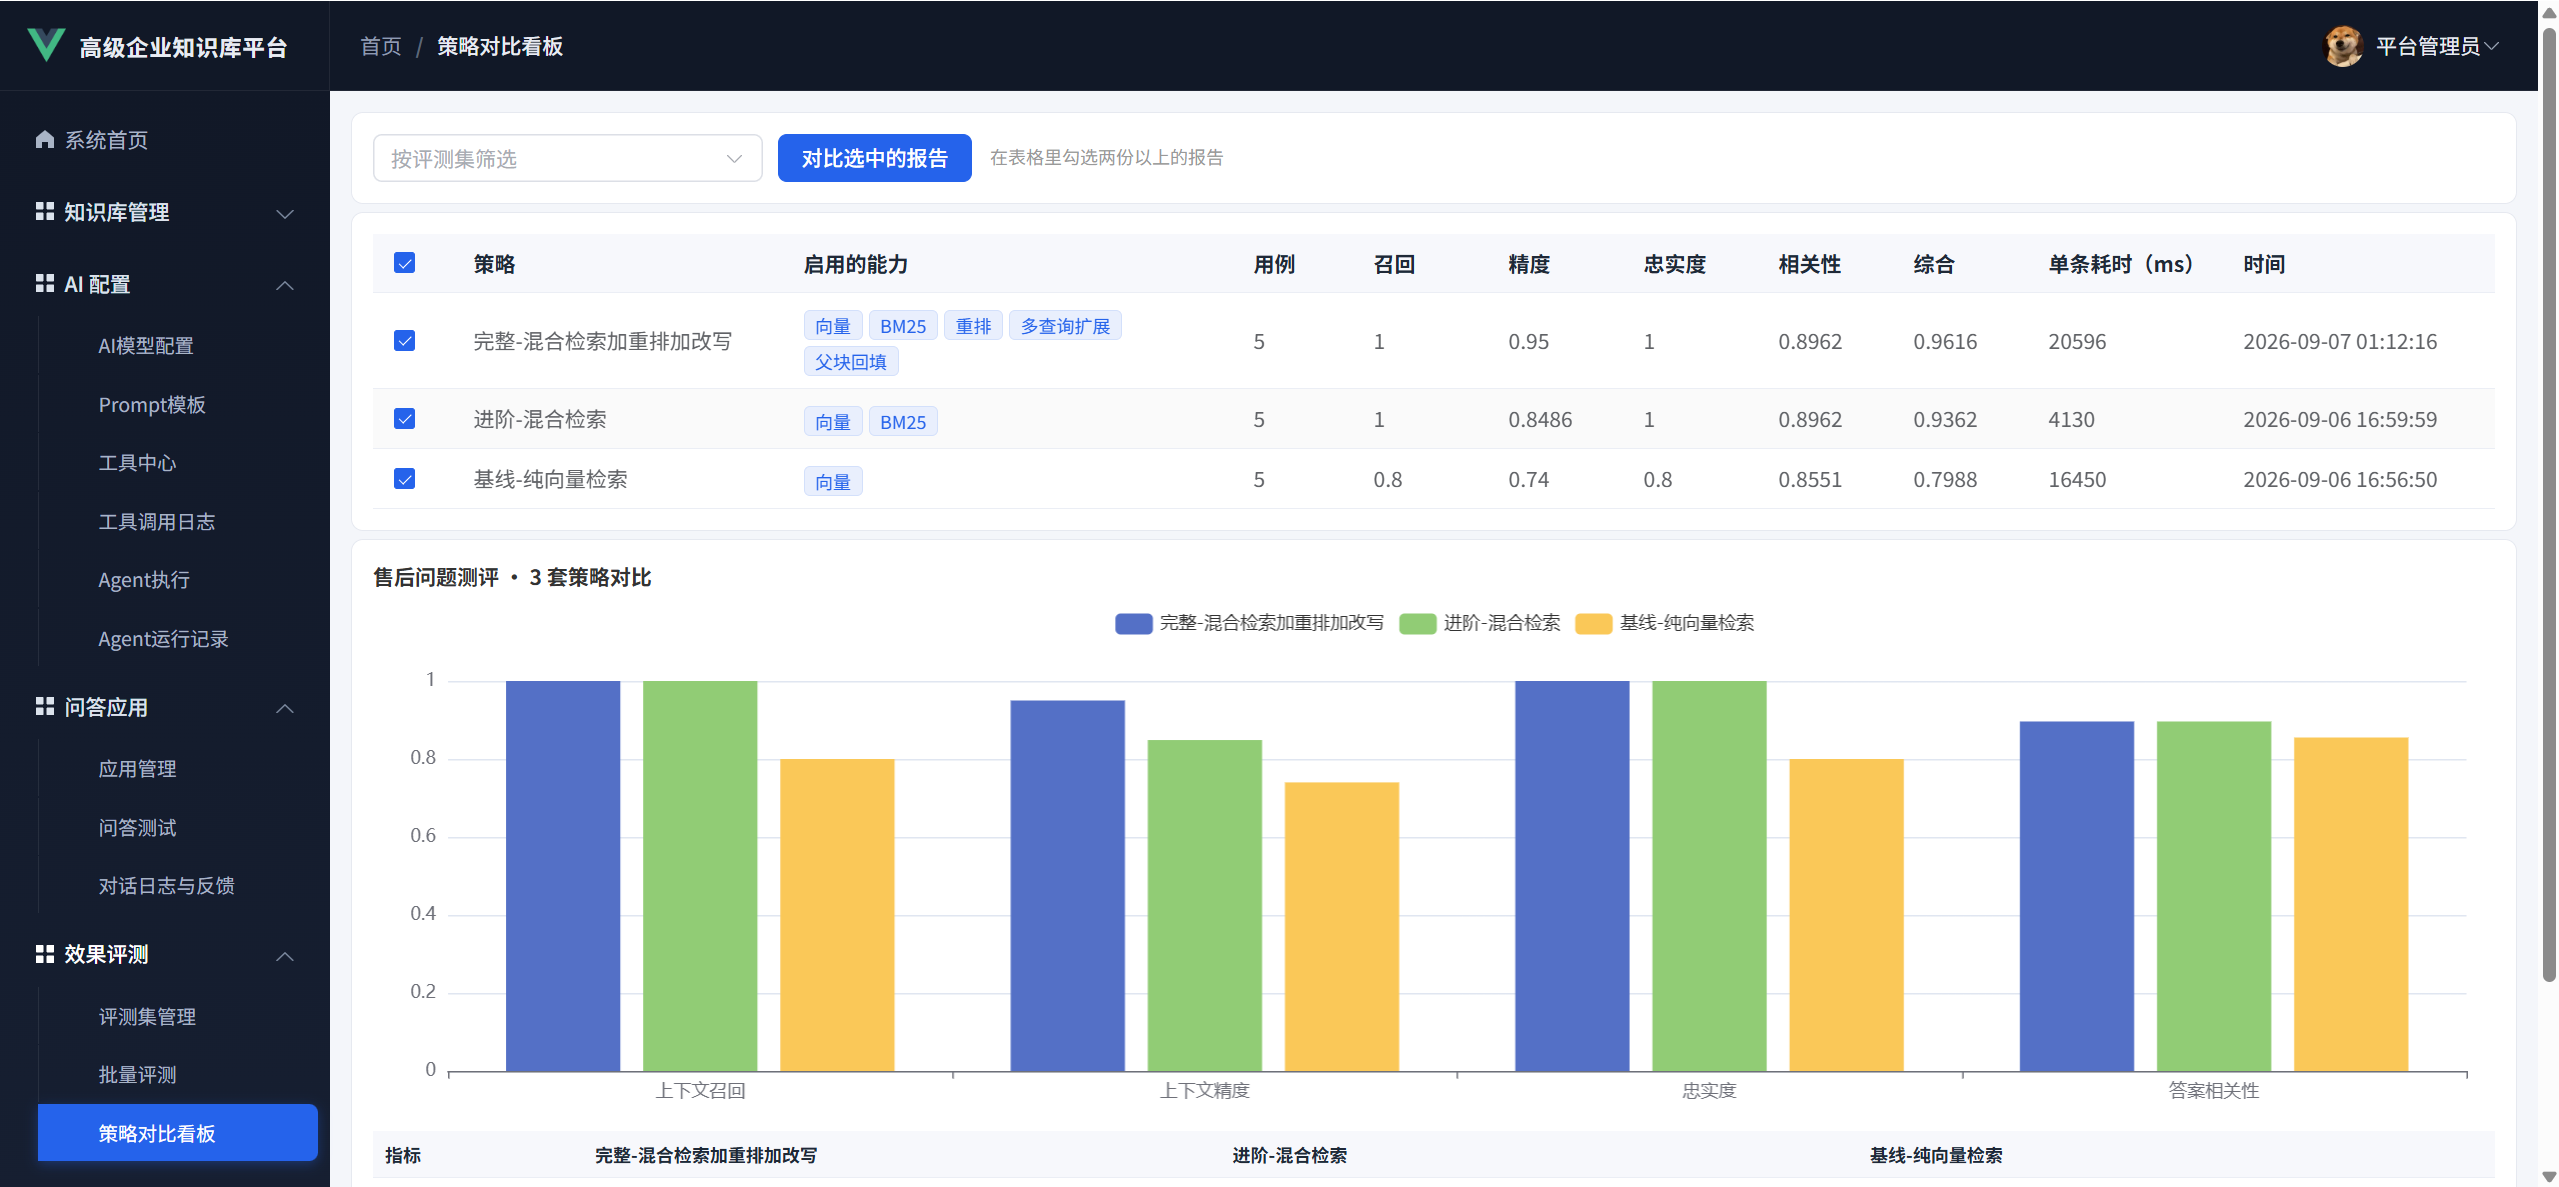
- 策略对比看板多份报告并排,柱状图对比每一步优化带来的分数变化
系统2 项
- 用户管理管理系统所有用户
- 个人资料登录、个人资料、修改密码
页面截图
共 11 张真实运行截图,点击大图查看高清原图。
 点击放大
你将获得
购买后可以拿到的全部内容。
喂饭级学习教程31 章
从工程底座、文档解析、向量化,到高级检索、Agentic RAG、效果评测,按开发顺序一章一章讲,每章都有验证步骤。
完整源码 + SQL196 条自动化测试
FastAPI 后端 67 个模块 + Vue3 前端 30 个页面,MySQL 25 张业务表与 PGVector 建表脚本、初始化数据。
配套面试文档
电梯陈述、架构与选型、检索 / Agent / 评测追问、取舍与难点包装,面试时照着讲。
环境安装文档
Windows 本地安装 PostgreSQL 与 PGVector,Python 虚拟环境与依赖版本全部锁定。
项目运行文档
两个数据库、前后端从零跑起来,再走通一条完整链路,常见问题都有排查办法。
常见问题
下单前最常被问到的几个问题。
这个项目是 Java 还是 Python?
后端是 Python(FastAPI + LangChain + LangGraph),前端是 Vue3。依赖版本全部锁定,教程里每一行代码都以锁定的版本为准。
模型需要自己准备吗?
需要自己开通阿里云百炼并创建 API Key,在管理端「AI 模型配置」里填入即可,改配置立刻生效,不用改代码、不用重启。三类模型都走接口调用,不需要显卡。
基础薄弱能学会吗?
教程是喂饭级的,从登录注册、统一返回这些工程底座讲起,每章都有验证步骤。基础不够的话,可以先按上面的「学习路径」从基础项目学起。
能写进简历、用作毕业设计吗?
可以,配套面试文档里有项目介绍、难点包装和高频追问,照着就能讲清楚。至于毕业设计,有小伙伴问过我,统一回答一下:AI 实战库板块的项目拿去做毕业设计,就四个字——降维打击。
源码能用于商业项目吗?
源码和教程本质上是给大家学习、提升技能的。如果需要商用,自己二次开发一下也没问题,但禁止原项目 + 教程转手倒卖。我是一个程序员,能看到你们学习我的教程提升能力,能听你们叫我一声大佬,挺幸福的!知足~
售后答疑
买完不是结束跟着教程学习,遇到问题不用自己硬扛。