基于FastAPI+LangChain+LangGraph+Agent+多模态的AI Agent智能会议纪要辅助系统
项目简介:基于LangChain+LangGraph的AI Agent智能会议纪要辅助系统 包括会议管理 资料管理 音视频转写 说话人分离 会议纪要生成 Agent自检更正 Agent运行观测等。
资料包含
项目详情
一、项目技术栈
前后端分离
后端:FastAPI + Uvicorn + Tortoise ORM(异步,aiomysql 驱动)+ Pydantic 2 + PyJWT + HTTPX(异步调用模型接口)+ asyncio 后台任务
前端:Vue3 + Vite + Element-Plus + Vue-Router + Axios + ECharts(运行观测中心的调用趋势、调用类型分布、自检状态与步骤统计)+ fetch 读取 SSE 事件流
AI 技术:录音文件异步识别(提交任务 + 轮询结果)+ 说话人分离 + AI 说话人建议匹配 + 长转写分段提取与合并 + JSON 结构约束与 Pydantic 校验 + 反思环 Agent(审查 → 重写 → 复核)+ 修订稿人工确认 + SSE 运行状态推送 + 中断恢复 + AI 调用观测
文件处理:FFmpeg(提取单声道 16kHz 音轨、按 20 分钟切段)+ python-docx(DOCX 在线预览、纪要导出 Word)+ ReportLab(纪要导出 PDF)+ zipfile(ZIP 内部文件清单)
数据库:MySQL(账号、部门、会议、资料、转写、纪要、自检运行与模型调用日志)
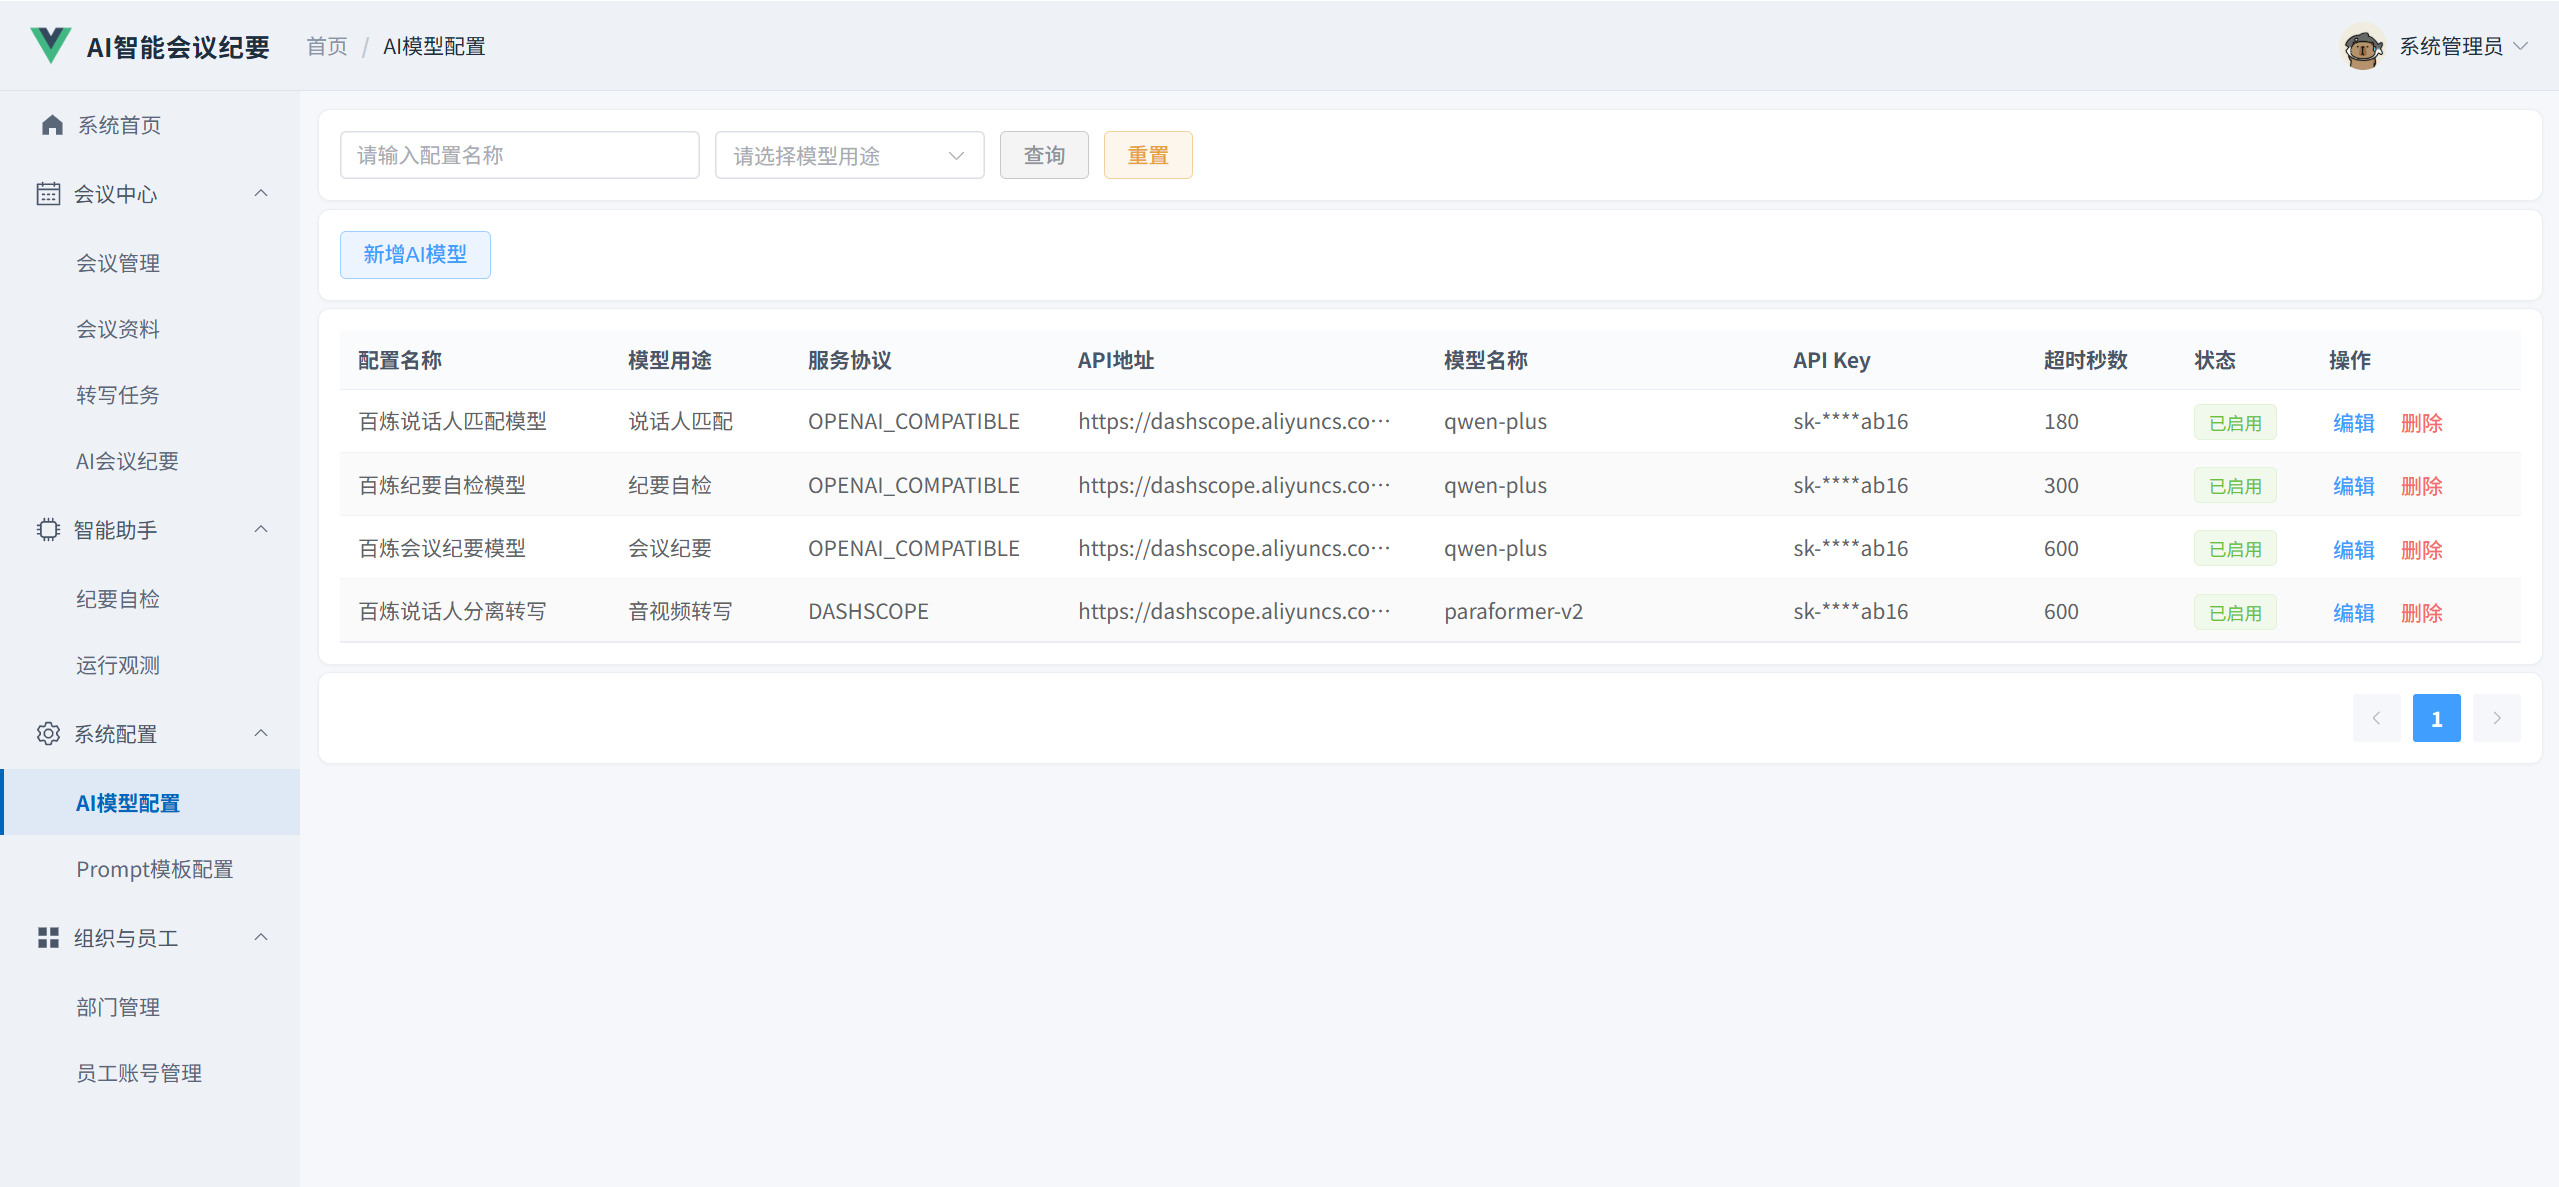
四种用途的模型都在管理端配置,同一用途只有一条处于启用状态,改完配置下一次调用立即生效,不用重启服务:
转写模型        paraformer-v2    百炼录音文件识别接口(DashScope 异步任务)
会议纪要模型    qwen-plus        百炼 OpenAI 兼容 Responses 接口
纪要自检模型    qwen-plus        百炼 OpenAI 兼容 Responses 接口
说话人匹配模型  qwen-plus        百炼 OpenAI 兼容 Responses 接口
版本要求:
Python 不低于 3.10(开发环境 3.12),MySQL 8,node.js 版本 18 以上,FFmpeg 6 及以上并加入系统 PATH,navicat 建议不低于 16
导出 PDF 需要系统里有中文字体(Windows 自带的黑体 simhei.ttf 或微软雅黑 msyh.ttc 即可)
二、项目功能描述
1. 管理员
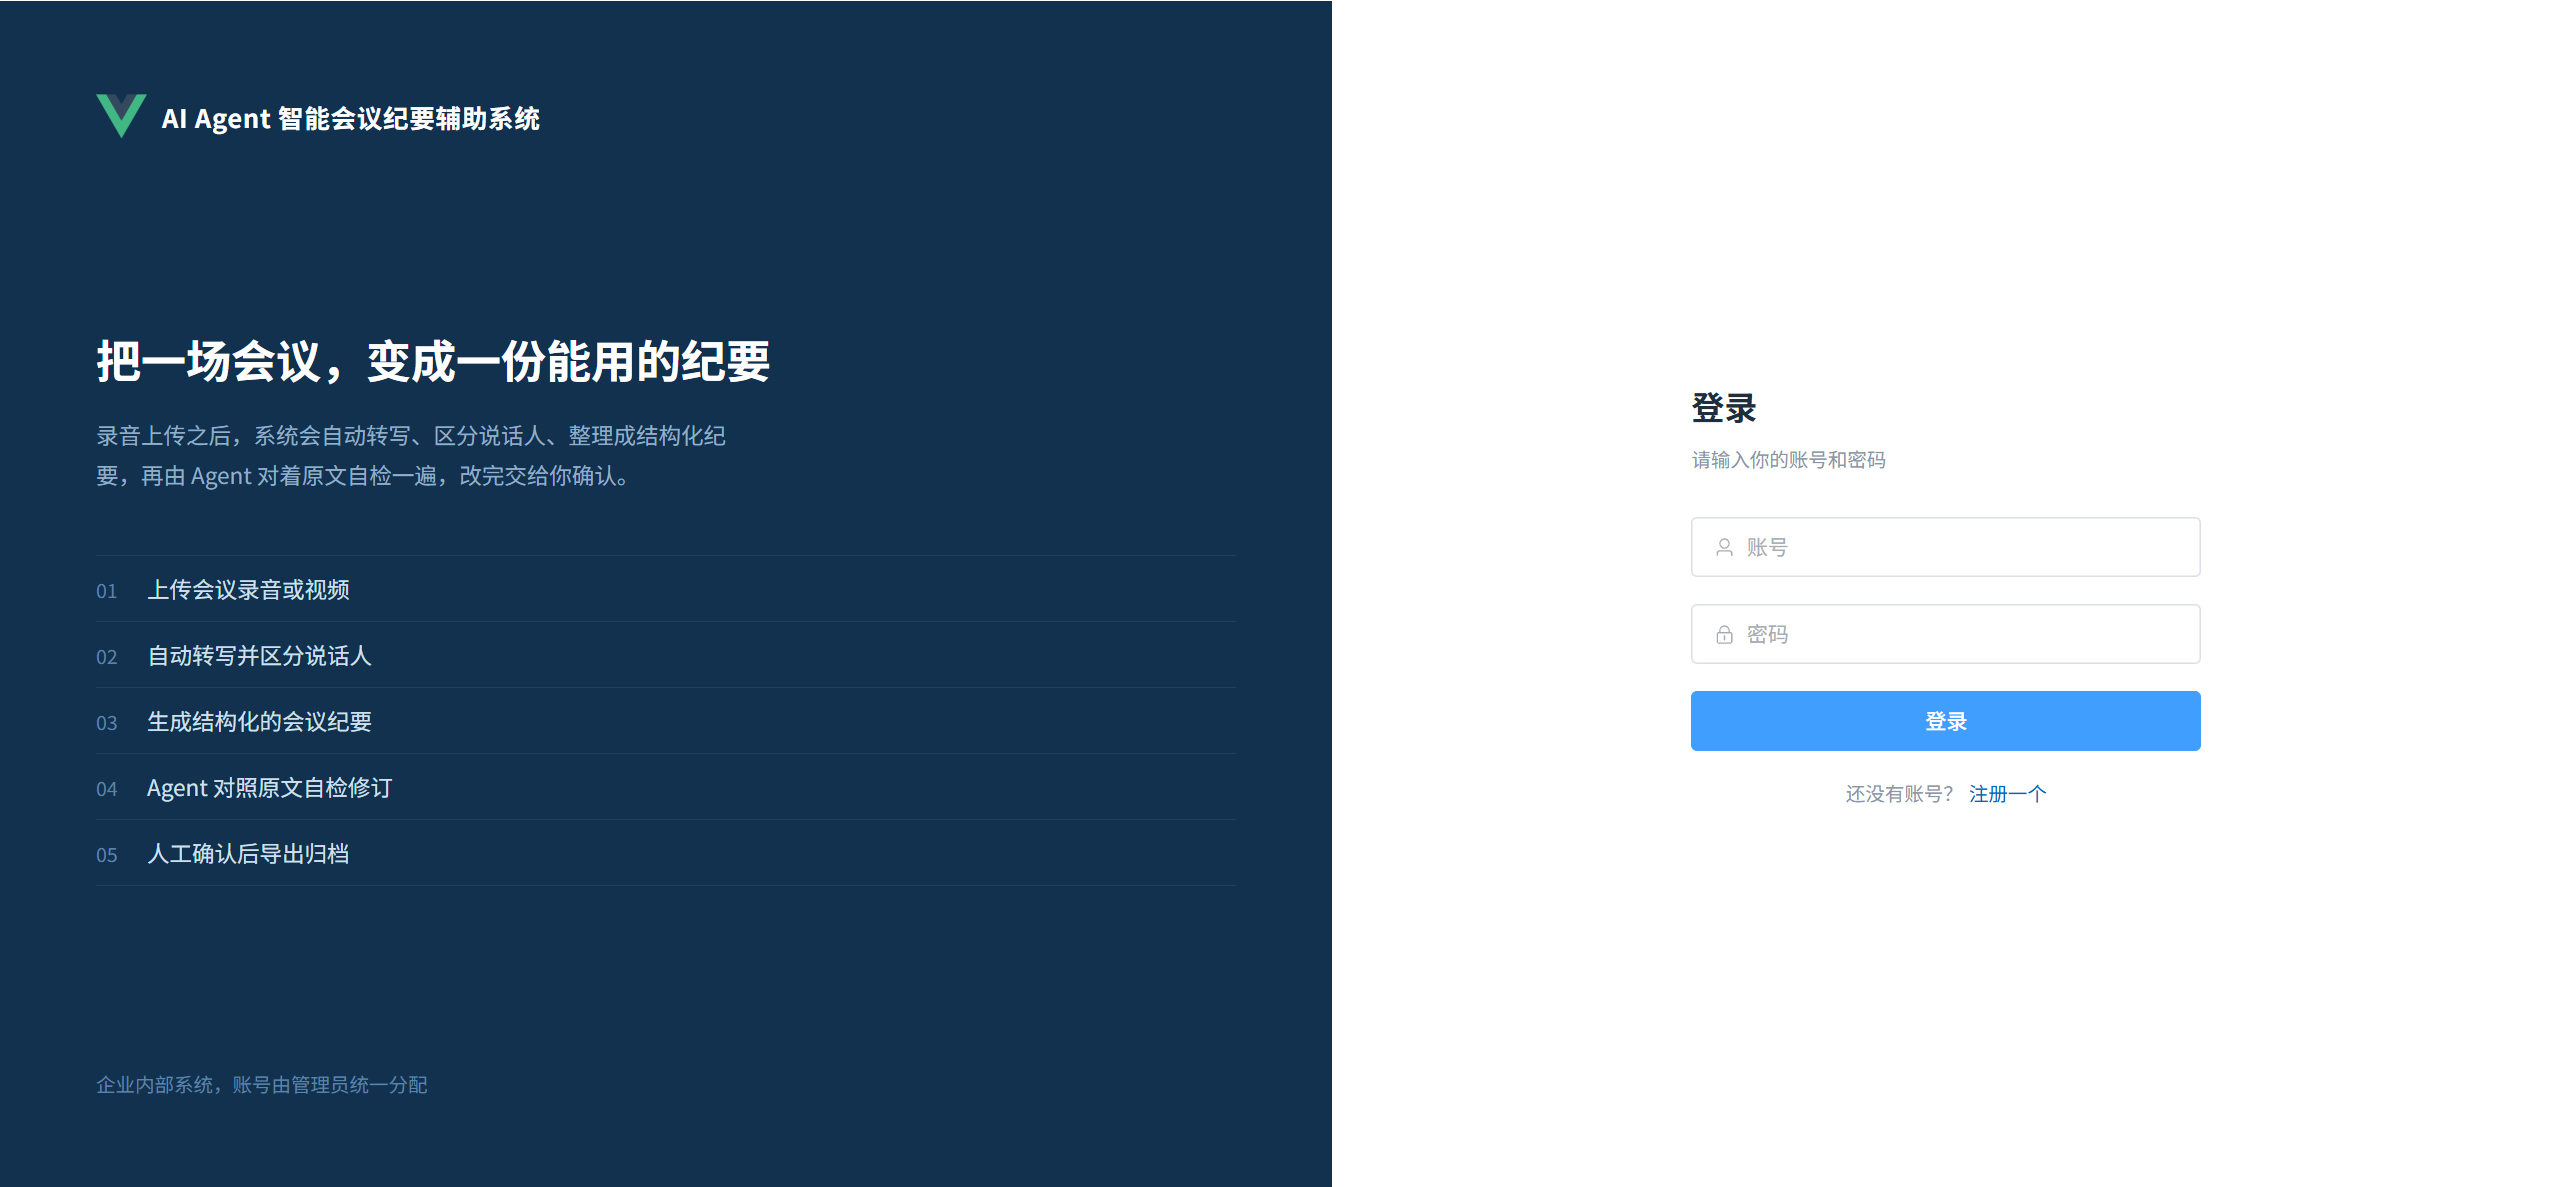
登录、个人资料、头像上传、修改密码、退出登录
系统首页:我的会议、转写任务、会议纪要(含已确认数)、纪要自检四张统计卡片,最近会议与最近纪要各五条
组织与员工
部门管理:按名称和状态查询,新增、编辑、删除、批量删除,列表显示部门员工人数,部门下还有员工时不能删除
员工账号管理:按姓名、角色、部门查询,新增(不填密码默认 123456)、编辑、删除、批量删除,维护头像、角色、部门、职位与启停状态;已关联会议、转写、纪要或自检数据的账号不能删除
会议中心
会议管理:创建会议,填写主题、起止时间、地点、议程,选择主持人与参会人员;按主题、状态查询,可切换全部会议 / 我的会议 / 我创建的 / 我参与的
会议状态流转:开始会议(最早提前 10 分钟,超过计划结束时间不能开始)、结束会议、取消会议并填写原因
删除会议:确认框先列出参会人、资料、转写、分段、纪要、自检运行各有多少条,确认后连同磁盘文件一起清理
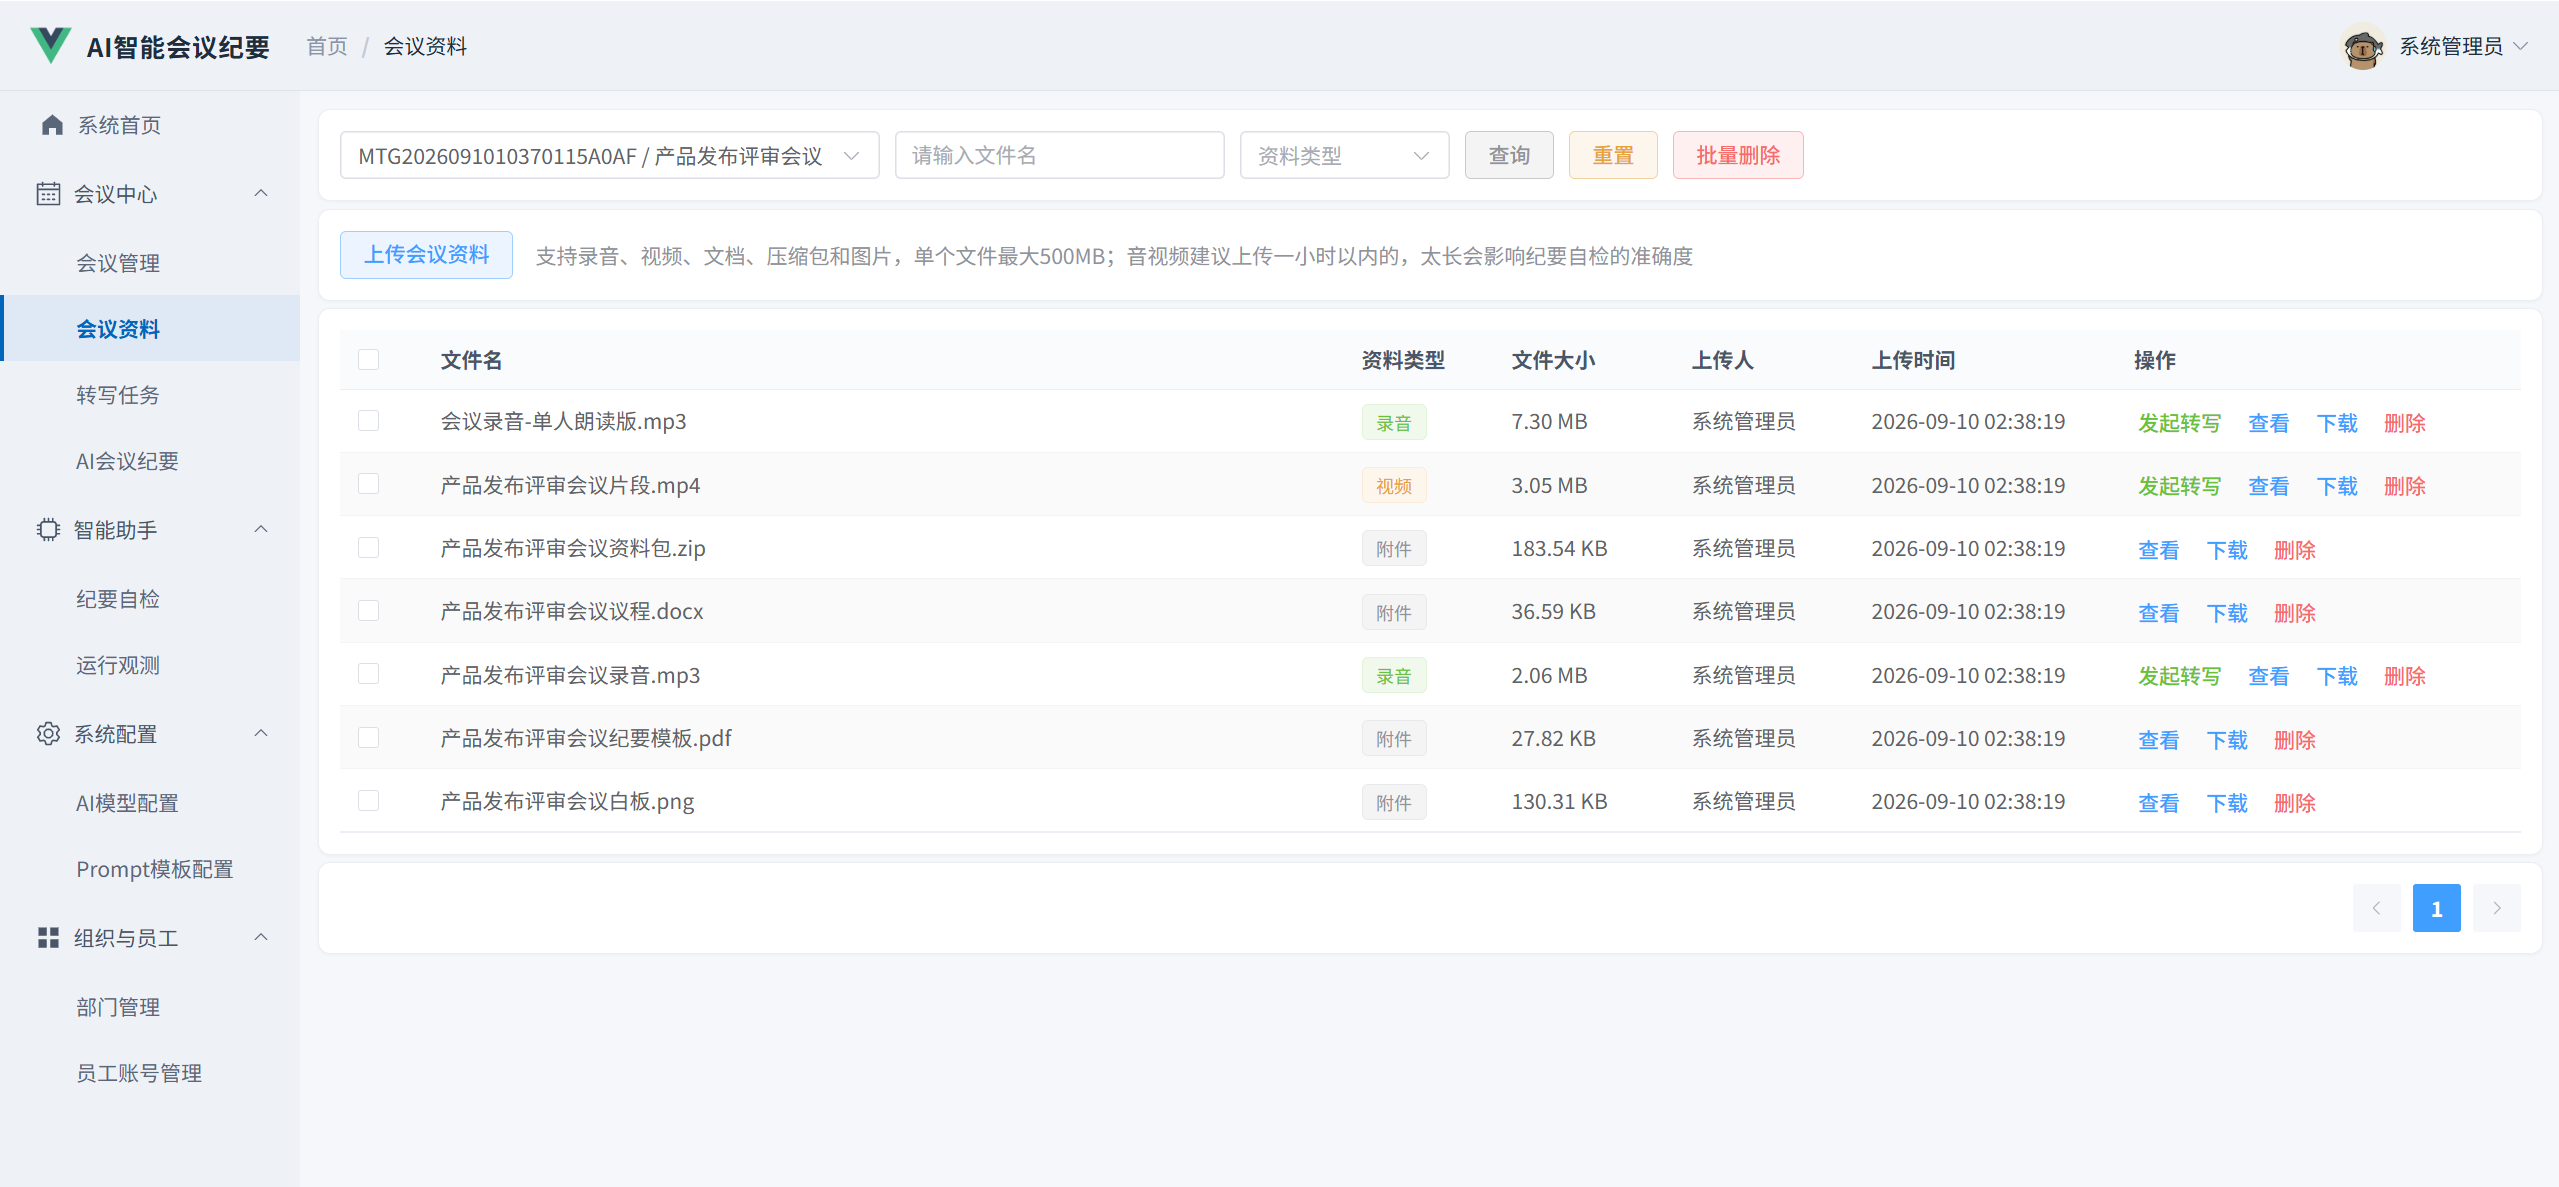
会议资料:上传录音、视频、文档、压缩包和图片(单个 500MB),同一会议内按 SHA-256 判重;按文件名和类型查询,下载、删除、批量删除
在线查看:图片、音视频、PDF、文本由浏览器直接呈现;DOCX 展示段落与表格;ZIP 展示内部文件清单
发起转写:在录音或视频行打开弹窗,选择中文、英文、日语、韩语或自动识别
转写任务:列表显示状态、进度、片段数、时长、重试次数,执行中的任务每 3 秒自动刷新;失败任务最多重试 3 次;删除任务时连带删除由它生成的纪要
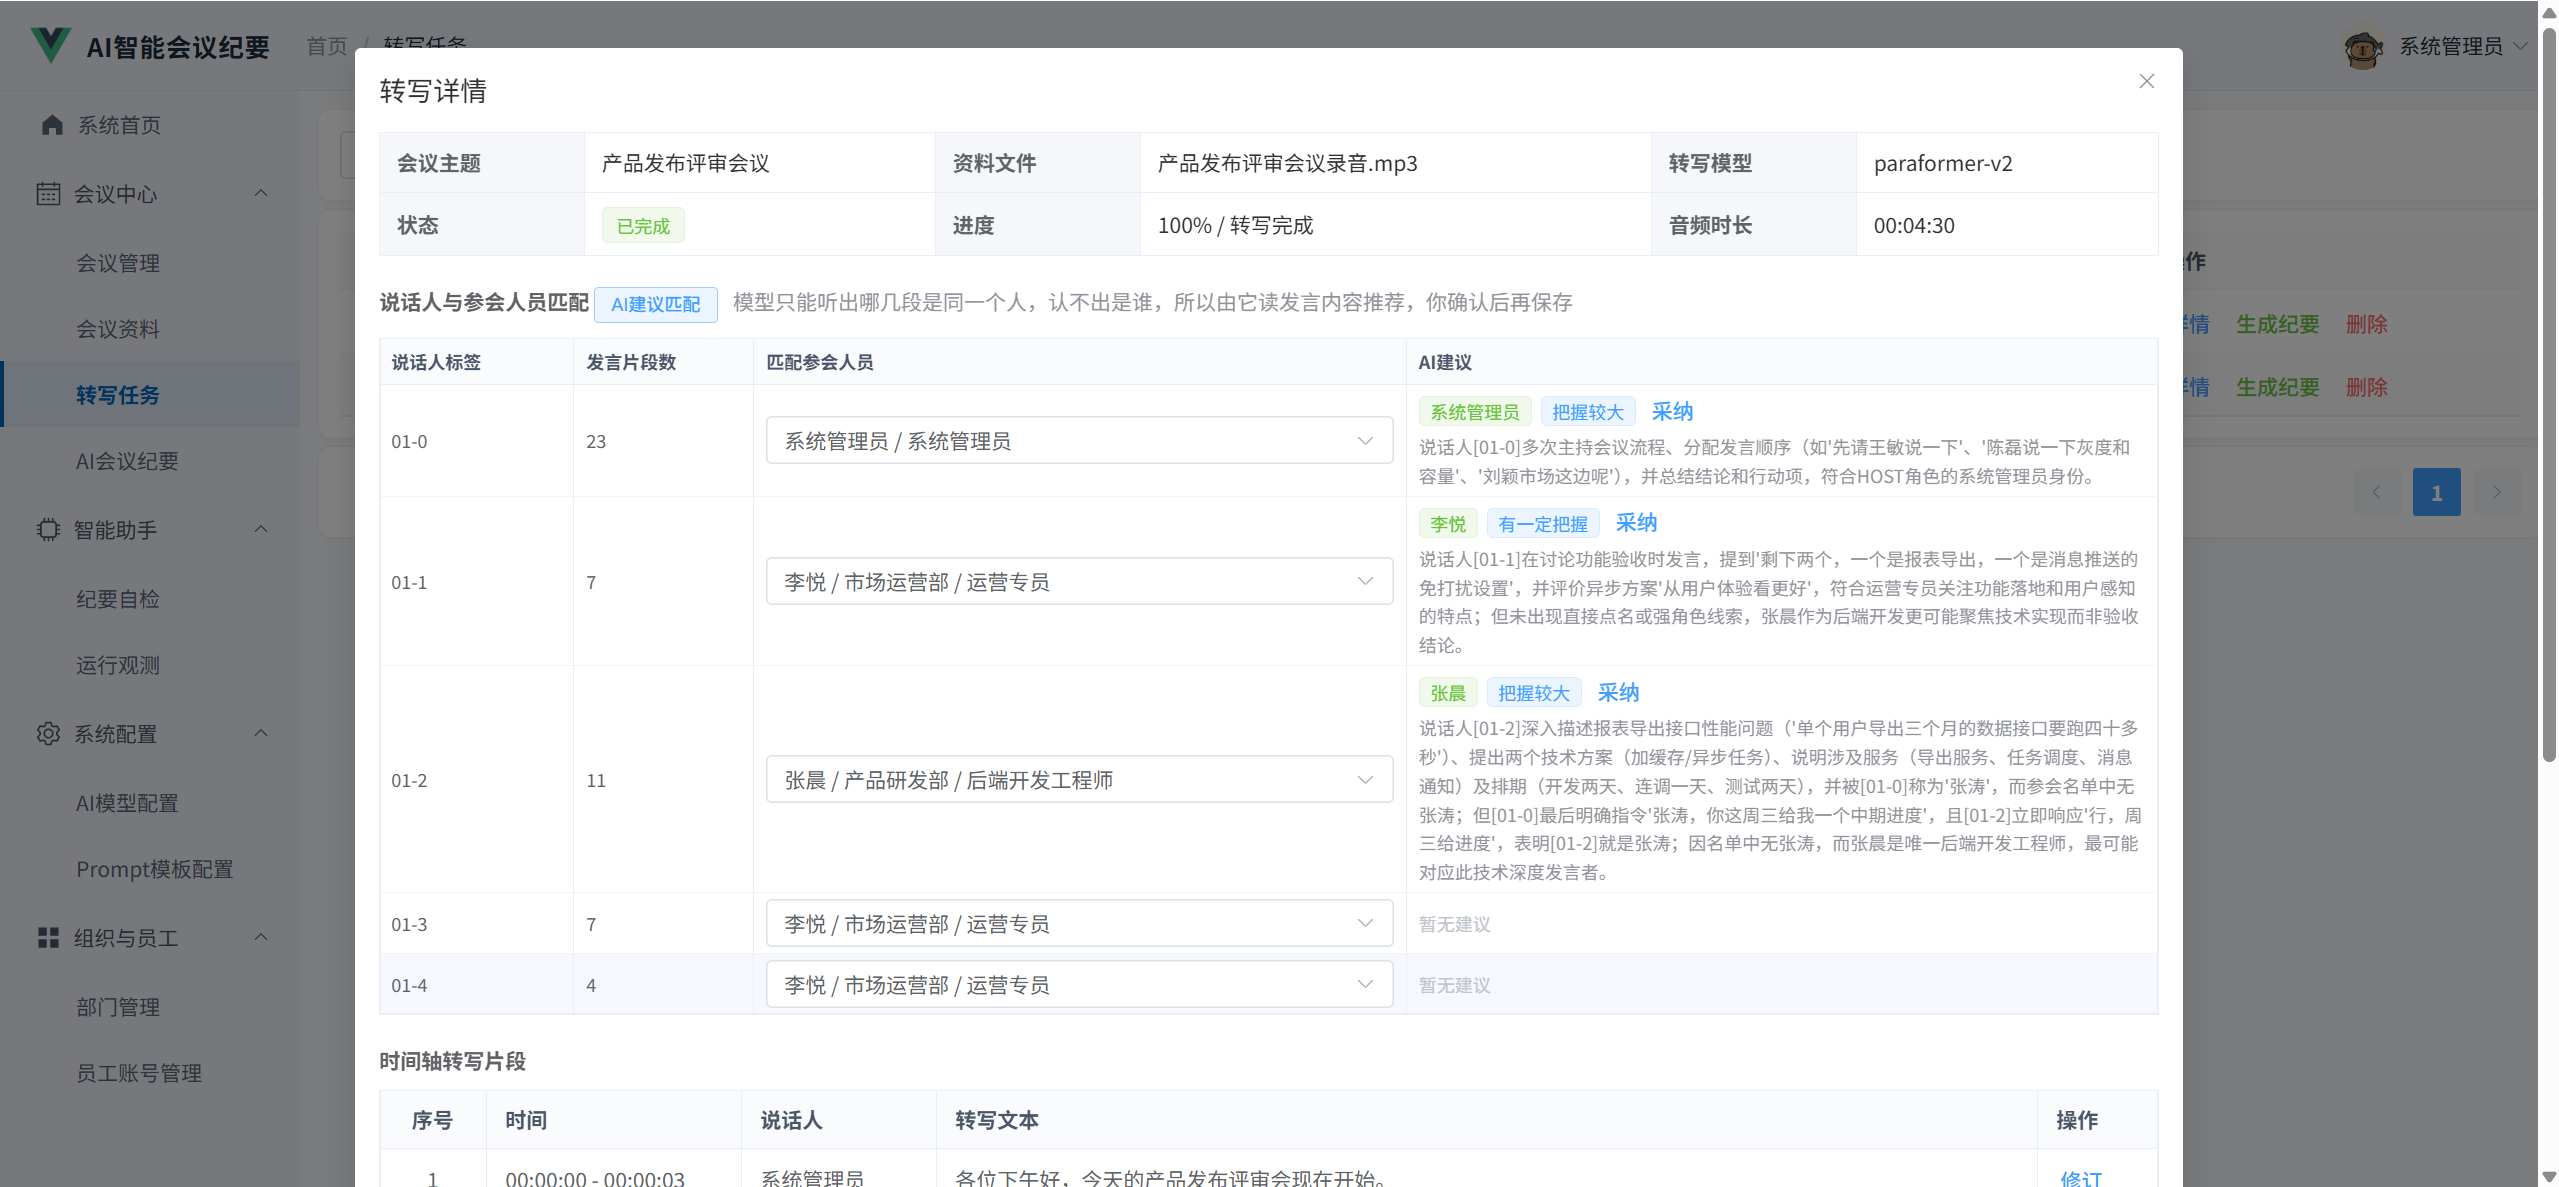
转写详情:按时间轴查看片段,逐段修订文本,把说话人标签匹配到参会人员
AI 建议匹配:模型读取发言内容和参会名单,给每个说话人标签推荐人选、依据和把握程度,点击采纳后才保存
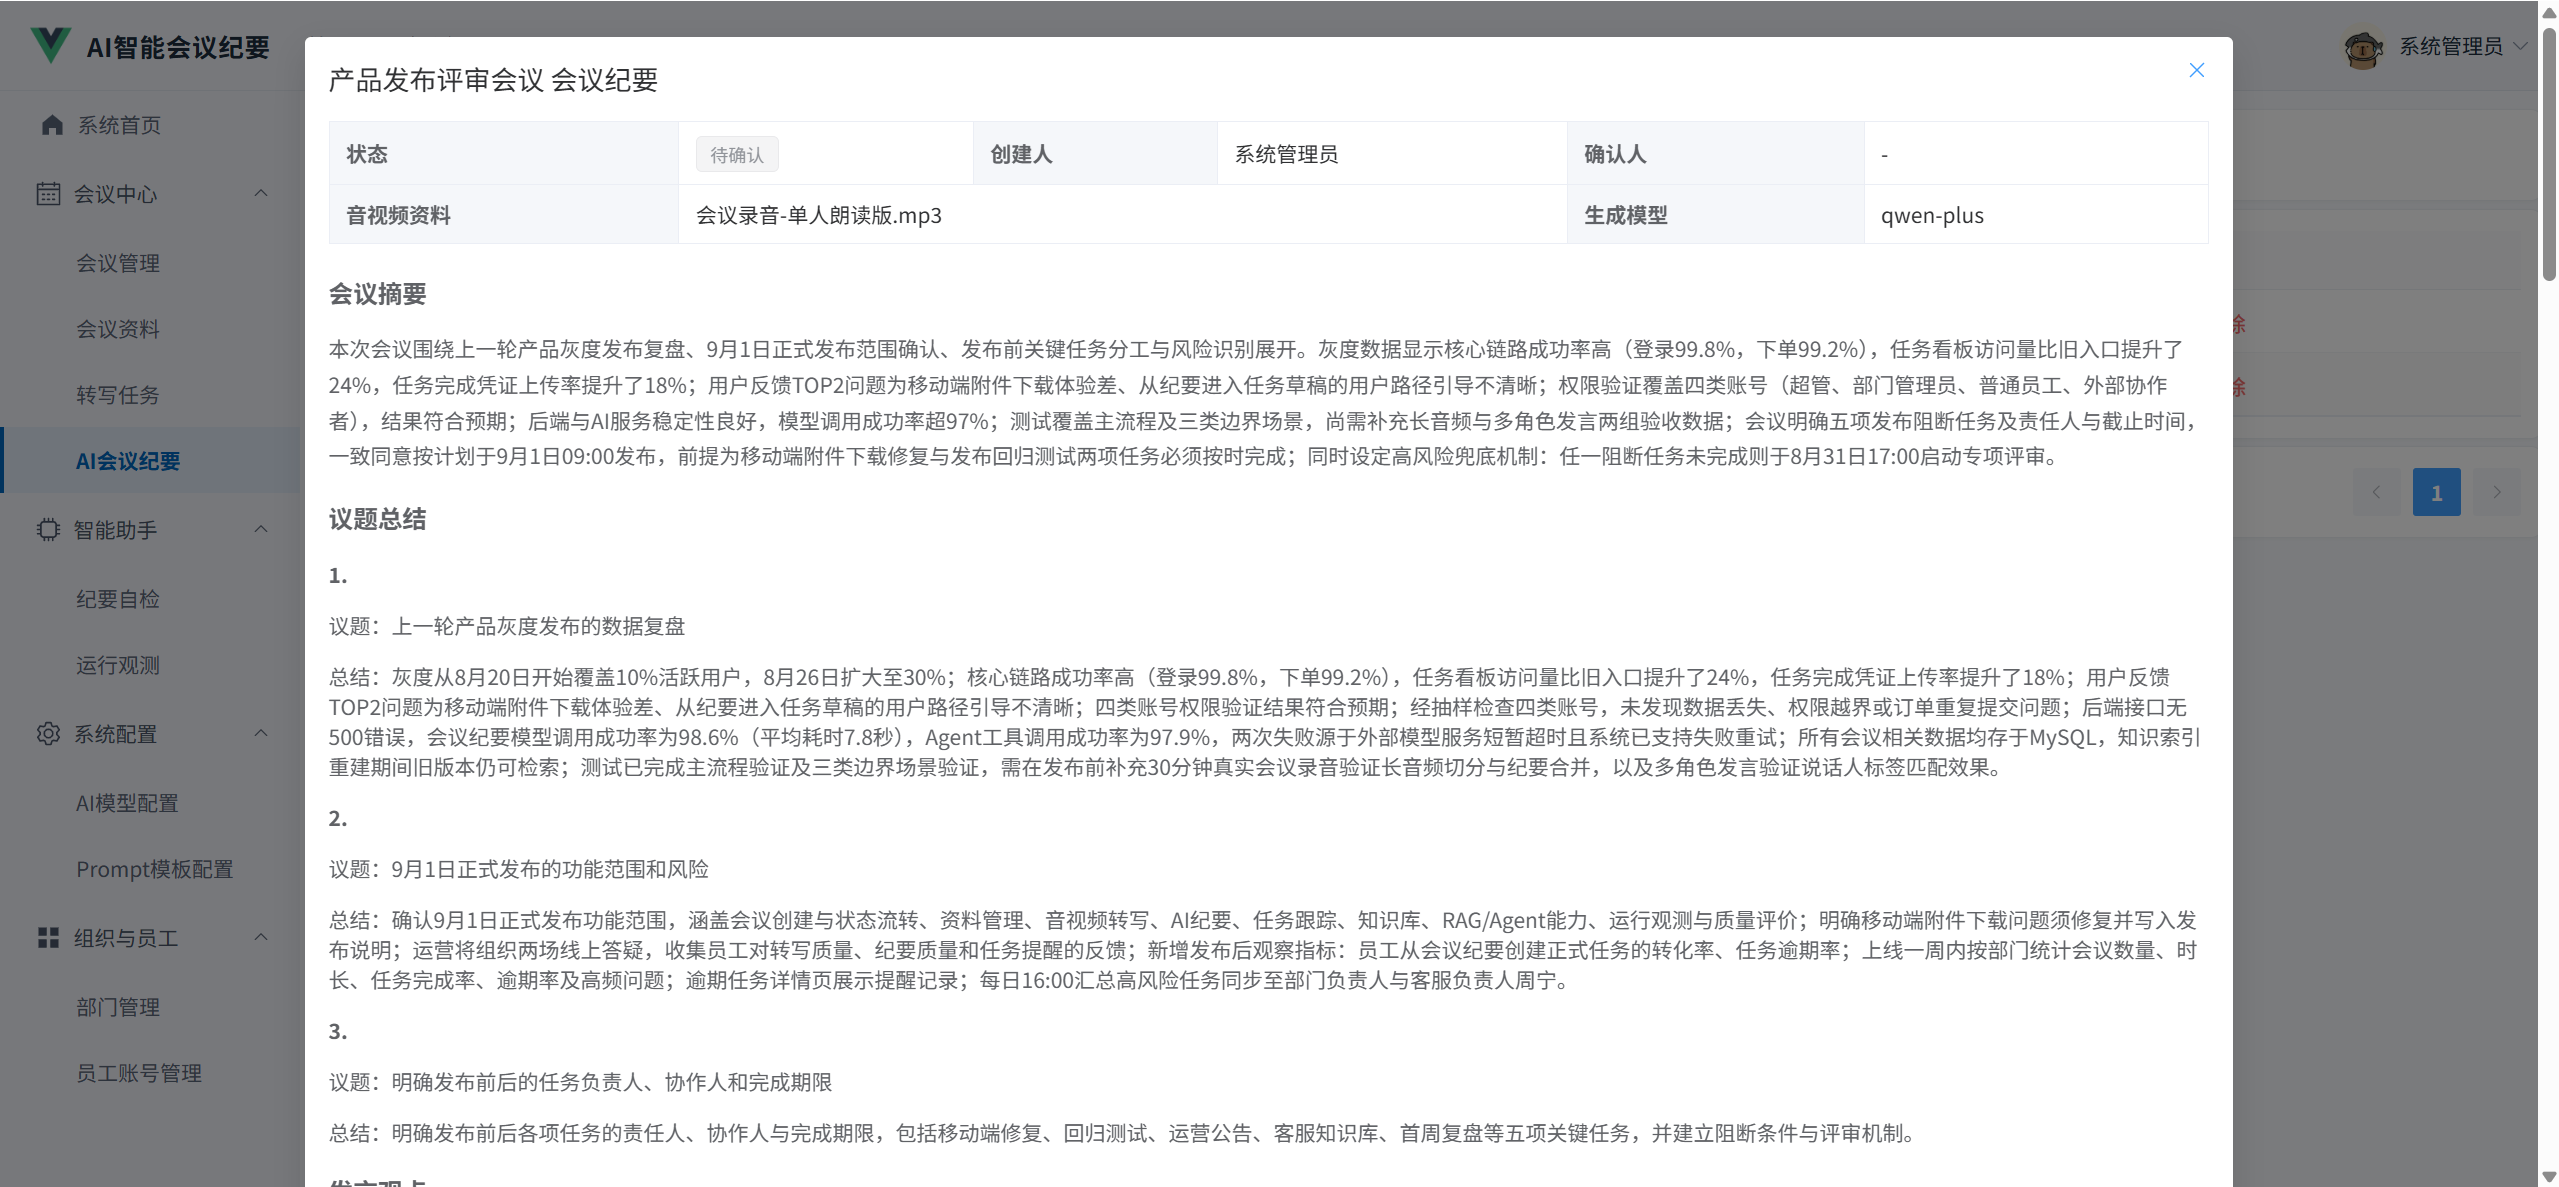
AI 会议纪要:从成功的转写任务生成摘要、议题、发言观点、决策、待确认事项、风险与争议六块内容;同一转写任务只保留一份纪要,重新生成会覆盖
纪要维护:查看详情、按条目增删改修订、确认、取消确认、失败重试、删除,导出 Word 与 PDF
智能助手
发起自检:在纪要列表点击「Agent自检」,Agent 对照转写原文检查纪要是否记全、决策和待办能否落实
纪要自检运行台:按会议主题和运行状态查询,列表显示进度、轮次、得分、发现问题数,运行中的记录每 3 秒自动刷新
自检详情:SSE 实时推送运行状态和步骤时间线,审查步骤展示判定、得分和问题卡片,可预览修订稿
人工确认:用修订稿覆盖原纪要,或填写原因放弃这次修订
运行控制:中断运行、恢复运行、删除非运行中的记录
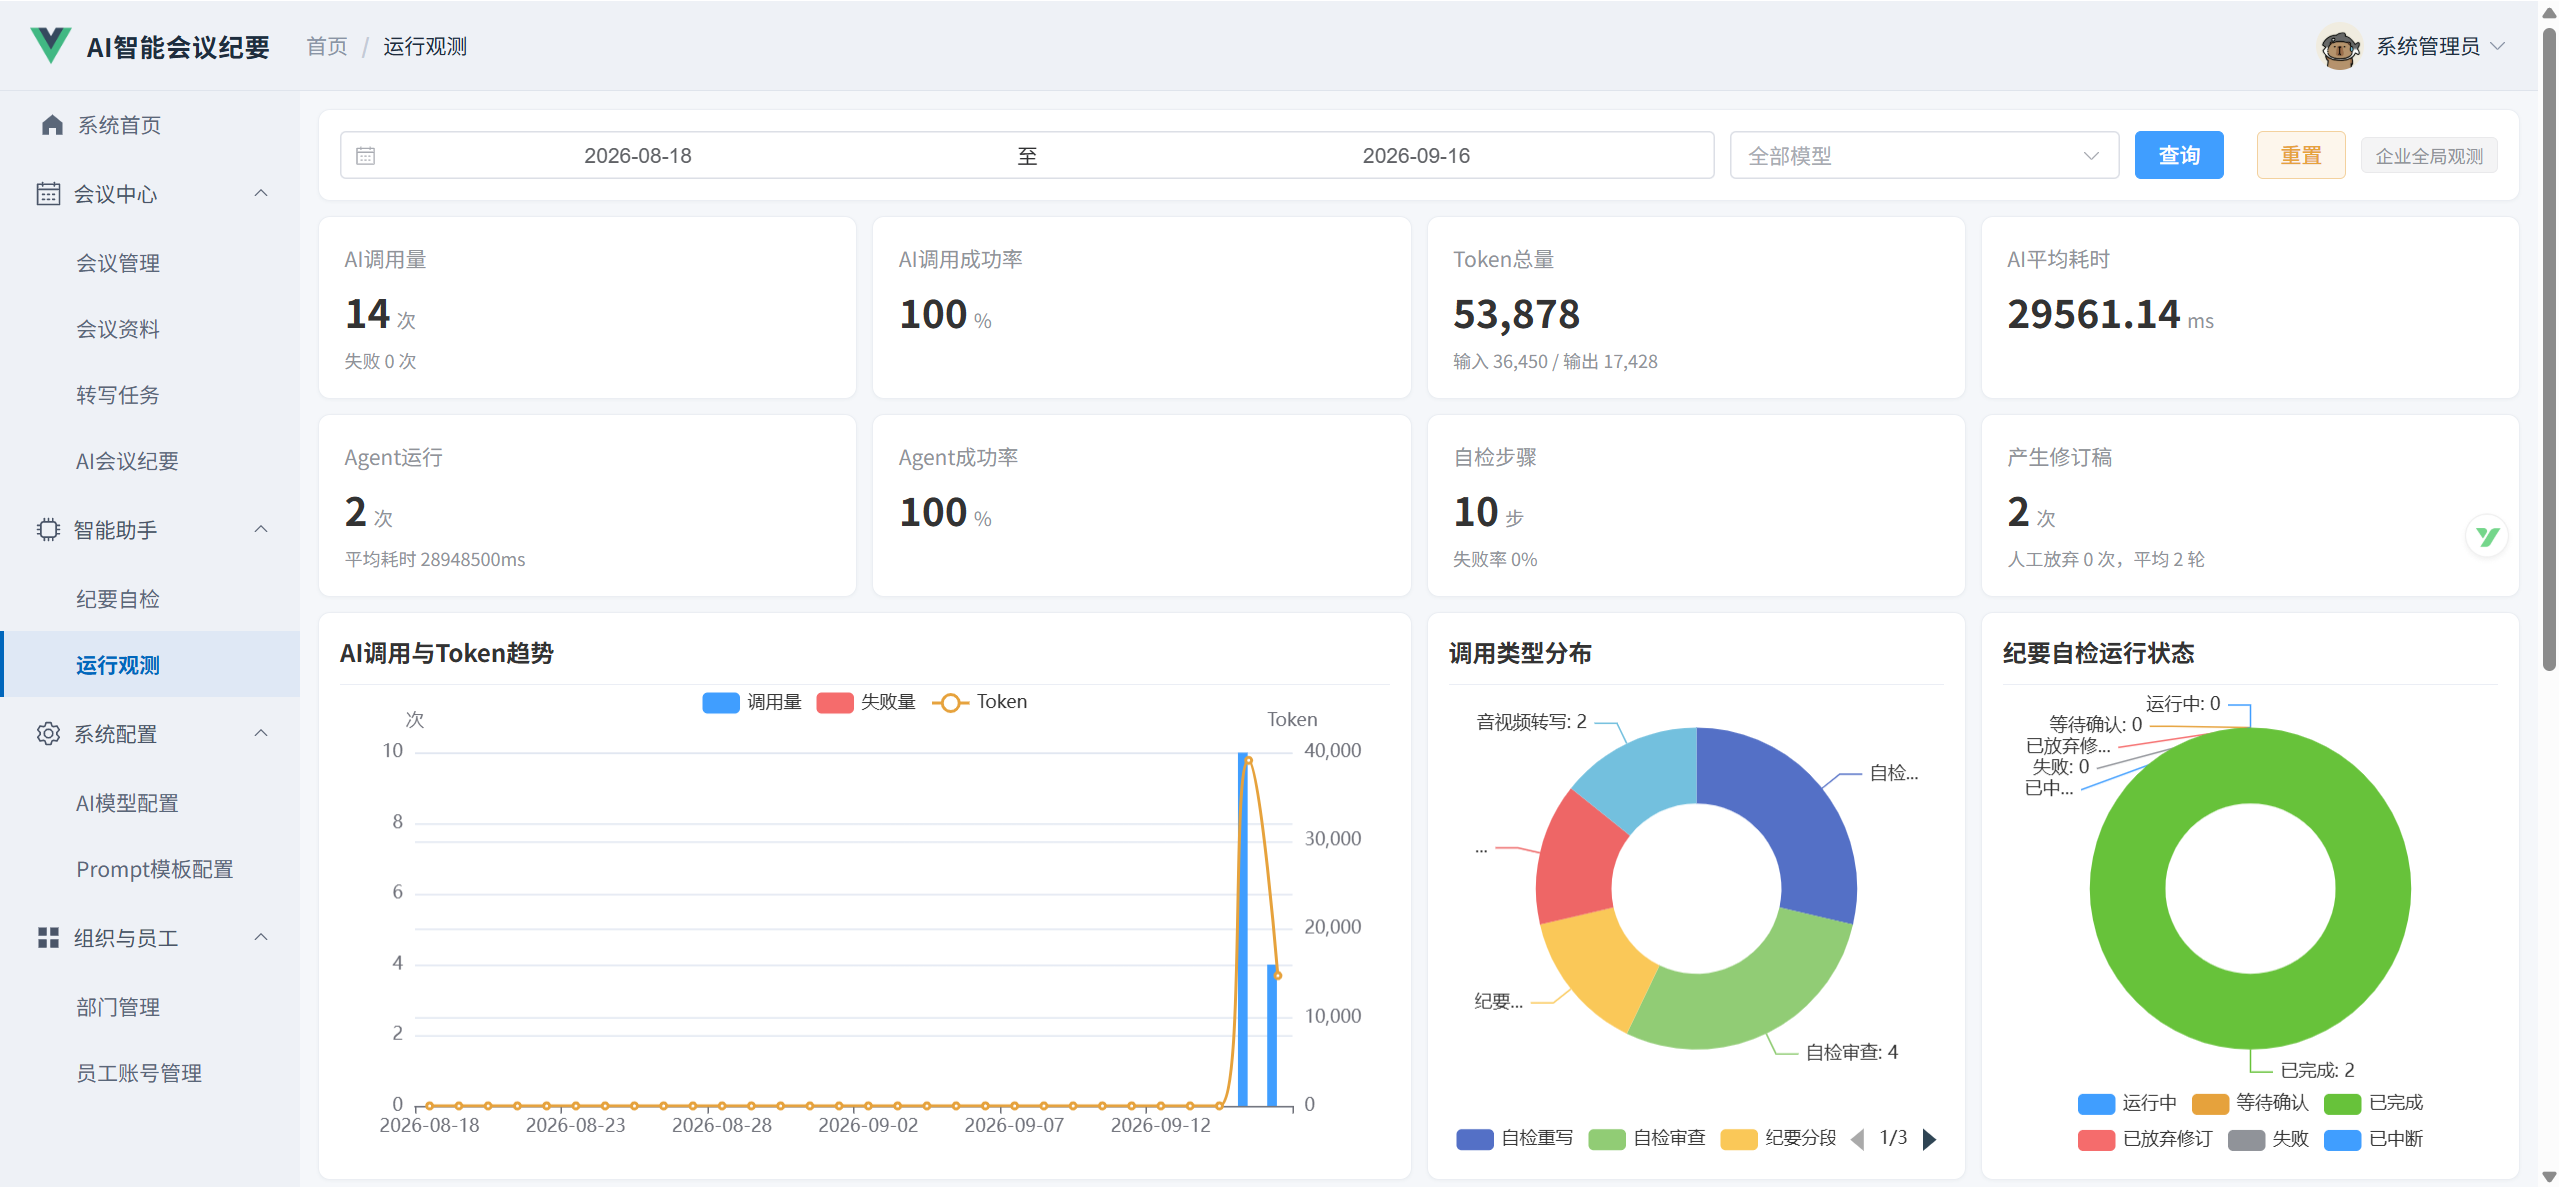
运行观测:按日期范围和模型筛选,查看 AI 调用量、成功率、Token、平均耗时、自检运行与步骤统计、调用趋势图、模型调用排行和最近失败记录
系统配置
AI 模型配置:按名称和用途查询,新增、编辑、删除四种用途的模型配置;启用一条会自动停用同用途的其他配置,列表中的 API Key 打码显示,已被业务数据使用的配置不能删除也不能改用途
Prompt 模板配置:按名称和应用场景查询,编辑五条系统预置模板的系统指令、用户模板与启用状态,保存时校验模板必需的变量占位符
2. 员工
登录、注册、个人资料、头像上传、修改密码、退出登录
系统首页:会议、转写、纪要卡片按本人可访问的会议统计,纪要自检卡片只统计本人发起的运行,最近会议与最近纪要各五条
所在部门成员:查看本部门在职成员的姓名、职位、电话、邮箱与头像
会议:创建会议;查看自己创建、主持或参加的会议;编辑自己创建且尚未开始的会议;作为创建人或主持人开始、结束、取消会议
会议资料与转写:在可访问的会议里上传、查看、下载、删除资料,发起转写,修订转写文本,匹配说话人,使用 AI 建议匹配;删除转写任务需要是转写发起人
会议纪要:在可访问的会议里生成、修订、确认、重试、导出纪要;删除纪要和取消确认需要是纪要创建人
纪要自检:对可访问的纪要发起自检,运行台只显示自己发起的运行;用修订稿覆盖或放弃修订还需要是纪要创建人
运行观测:统计范围限定为本人发起的转写、本人创建的纪要和本人发起的自检所产生的模型调用与运行记录
管理员与员工共用同一个管理端,菜单按 user.role 显示;后端再按会议创建人、主持人、参会关系、转写发起人、纪要创建人和自检发起人分别校验每个操作的权限。
三、项目亮点
- 反思环 Agent:重写几轮由模型的审查结论决定,而不是写死在代码里:一轮等于「审查一次 + 按问题改一版」。审查步骤要求模型输出
passed、score、issues和总评,模型判定通过或者一条问题都没挑出来,环当场结束;否则把问题清单交给重写步骤改出新一版,没到轮数上限就回到审查复核这一版。页面发起时上限是两轮,所以第一轮改出来的稿子一定会被再审一遍;同一份纪要跑两次,可能第一轮就通过,也可能改两版才停,代码只负责兜住上限。每一步都落成agent_step(步骤号、轮次、类型、结构化产物、耗时),运行台用时间线把整个过程回放出来。 - 审查标准拆成「记全了没有」和「能不能落实」两组,解决"纪要被删空也能判通过":如果只检查决策有没有负责人和完成时间,模型把议题整块删掉反而更容易过审。所以审查模板分两组标准:完整性对照转写原文检查六块内容有没有漏记,可落实性检查决策和待办有没有负责人、完成时间、是否含糊,另外还查原文里找不到依据的内容。问题类型收敛为六个枚举,每条问题带
field和index定位到具体哪一块第几条,整块为空时index填 -1,页面据此渲染成问题卡片,重写步骤拿到的也是逐条可定位的修改意见。 - 修订稿不自动写回,人工确认是 Agent 唯一的写操作出口:重写结果每改一版就存进
agent_run.revised_json,运行结束进入「等待人工确认」,纪要表一个字都不动。人点「用修订稿覆盖原纪要」才把六个内容字段整体写回;点「放弃」要填原因,修订稿保留可回看。确认接口用status='WAITING_CONFIRMATION'作为更新条件抢占这条运行,两个人同时点确认只有一个能成功;已确认归档的纪要必须先取消确认,才允许被修订稿覆盖。 - 中断恢复与服务重启续跑,接着上一版稿子继续而不是从头再来:中断接口先用条件更新把状态从 RUNNING 改成 INTERRUPTED,再取消后台协程;主流程每轮开头重新读一次运行记录,状态不是 RUNNING 就退出。恢复时轮次从
current_round往后接,待审内容取revised_json里上次改到的那一版,步骤号按已有条数续编,不会和已有记录撞唯一索引。服务启动时还会把停在 RUNNING 的自检、GENERATING 的纪要和执行中的转写任务重新调度起来。 - 长音频转写:切段、上传、异步识别、时间轴重新拼接:FFmpeg 把录音或视频转成单声道 16kHz 音轨并按 20 分钟切段;每段先向百炼申请临时上传凭证,把文件传到百炼分配的存储空间换回
oss://地址,再提交开启说话人分离的异步识别任务,每 5 秒轮询一次结果。各段的句子时间换算成毫秒后叠加前面分段的时长,拼成一条完整时间轴;每段的说话人编号各自从头计数,所以标签加上分段前缀(如01-0、02-0),不会把不同分段的同号说话人误并成一个人。转写任务同时最多执行两个,FFmpeg 放进线程执行,避开 Windows 上 uvicorn 事件循环不支持异步子进程的问题。 - 说话人匹配:模型只给建议,写库由人决定:转写模型只能分辨"哪几段是同一个人",认不出这个人是谁。建议匹配把参会人员名单(
user_id、姓名、职位、会议角色)和带标签的前 120 段发言交给模型,要求点名句优先、拿不准就填 0。返回结果在后端二次过滤:本任务里不存在的标签、名单以外的user_id一律丢弃。页面展示建议人选、依据和把握程度,人点「采纳」后走的仍是手动匹配的同一个接口和同一套参会人员校验。匹配结果还会影响后面的纪要:切分转写文本时,已匹配的片段用真实姓名替换说话人标签。 - 长转写先分段提取再合并,六块结构化内容分别入库:转写片段按
[秒数][说话人] 内容逐行拼接,累计长度再加一行就超过 12000 字符时切出一段,每段调用分段提取模板得到一份结构化结果;只有一段时直接作为纪要,多段时再调用合并模板去重合并。最终结果拆成摘要文本和五个 JSON 数组字段分别保存,页面按条目展示和编辑,导出 Word、PDF 也按这六块排版;自检的重写步骤复用同一份结构定义和校验模型,修订稿因此可以原样覆盖回纪要。 - 每一次模型调用都留痕,观测中心的每个数字都能反查到表:转写、纪要分段与合并、自检审查与重写、说话人匹配六类调用,成功失败都写一条
ai_call_log(调用类型、业务 ID、模型、请求与响应字节数、耗时、模型返回的用量统计、失败原因)。观测接口按东八区自然日归档调用趋势,Token 同时兼容input_tokens与prompt_tokens两种字段命名,模型排行按配置主键分组;自检指标来自agent_run与agent_step,包括运行成功率、平均轮次、产生修订稿次数和人工放弃次数。员工视角先按转写发起人、纪要创建人和自检发起人找出本人的业务 ID,再过滤调用日志。
四、项目规模
MySQL 13 张业务表
教程文档 18 章(00—17)+ 项目简介 + 面试文档
后端 Python 模块 26 个,自动化测试 37 条
前端 Vue 页面 18 个
五、项目关键截图
🔥 限时优惠,已省 ¥210
不知道怎么学?点我
✓ 购买前请阅读须知