AI企业知识库
项目简介:基于文档解析、文本切片、Embedding、PGVector和RAG问答,实现知识库管理、资料上传、智能检索、企业问答、来源引用和模型配置管理,适合学习RAG落地与引用链路。
本项目覆盖的技术点
学完能答的面试题
学完这个项目,下面 12 道面试题你都能结合项目细节讲出来。题目在 AIGC 面试刷题网可以免费看。
系统架构
一张图看清整个系统的分层与核心链路,点开可缩放查看细节。
- 1接入层:AI 客服 + 知识库管理用户端首页和 AI 客服弹窗,能看到答案与资料来源;管理端做知识库、文档、片段三层管理和问答验证。
- 2知识入库链路(离线)知识库建分类时配好
chunkSize/overlapSize;文档上传后 PDFBox / POI 解析,按参数切片,再用向量模型写入 PGVector。 - 3RAG 问答链路(在线)问题先做 Embedding(前台用默认向量模型,管理端验证页可手选),PGVector 相似度检索,TopK 控数量、阈值砍掉不相关的;一条都没命中就不调模型,直接提示未找到资料,命中片段拼进 Prompt 再交给对话模型。
- 4回答与资料来源一起返回系统提示词约束只基于检索资料作答,同时返回命中片段来源:哪个知识库、哪份文档、哪一段。
- 5存储各司其职业务数据放 MySQL 8,向量只放 PostgreSQL 18 + PGVector;对话模型与向量模型分开配置,可分别替换。
技术栈
用到的框架、中间件和模型。
技术难点与解法
每一项优化都针对一个真实问题,讲清楚问题、做法和背后的原理。
01切片粒度与检索质量的平衡
- 问题
- 切片太粗,检索不准、浪费上下文;切片太细,一句完整的话被切断,语义丢了。
- 做法
- 用
chunkSize+overlapSize两个参数切片,相邻片段保留重叠;参数配在知识库上,不同资料可以用不同粒度。 - 原理
- 片段越小越好命中,但上下文越不完整;overlap 让被切断的语义在相邻片段里还能找回来。
02向量检索怎么落地
- 问题
- 向量检索听起来要单独上一套专业向量库,中小项目运维成本高、学习门槛也高。
- 做法
- 业务数据放 MySQL,向量放 PostgreSQL + PGVector,一套数据库就能做相似度检索;附 Windows 本地安装 PGVector 的完整教程。
- 原理
- Milvus 这类专业向量库在超大规模下更强,中小规模 PGVector 足够,还能少维护一套中间件。
03文本怎么变成能检索的向量
- 问题
- 关键词匹配听不懂同义表达,用户换个说法就检索不到相关资料。
- 做法
- 用 Embedding 模型把每个片段转成 1024 维向量写入 PGVector,用户问题也向量化后做相似度检索。
- 原理
- 语义相近的文本向量距离也近;入库和查询必须用同一个 Embedding 模型,否则向量不在同一个空间里,相似度没有意义。
04控制幻觉,让答案有据可查
- 问题
- 模型答得很流畅,但内容在企业资料里根本找不到出处,客服场景没法信任。
- 做法
- 检索结果拼进 Prompt 并约束「只根据参考资料回答,没有就说不知道」,回答同时返回命中的片段来源。
- 原理
- 答案可溯源是企业级客服可信的关键:用户能看到依据,管理员也能定位是资料问题还是检索问题。
功能清单
按角色看这个系统都能做什么。
知识库5 项
- 知识库管理创建知识库分类,配置切片长度与重叠长度
- 知识文档管理上传 PDF / DOCX / TXT / MD 文档,查看解析文本与解析状态
- 文档文本解析把上传的文档解析成纯文本
AI 问答2 项
- AI 模型配置分别维护聊天模型与向量模型配置
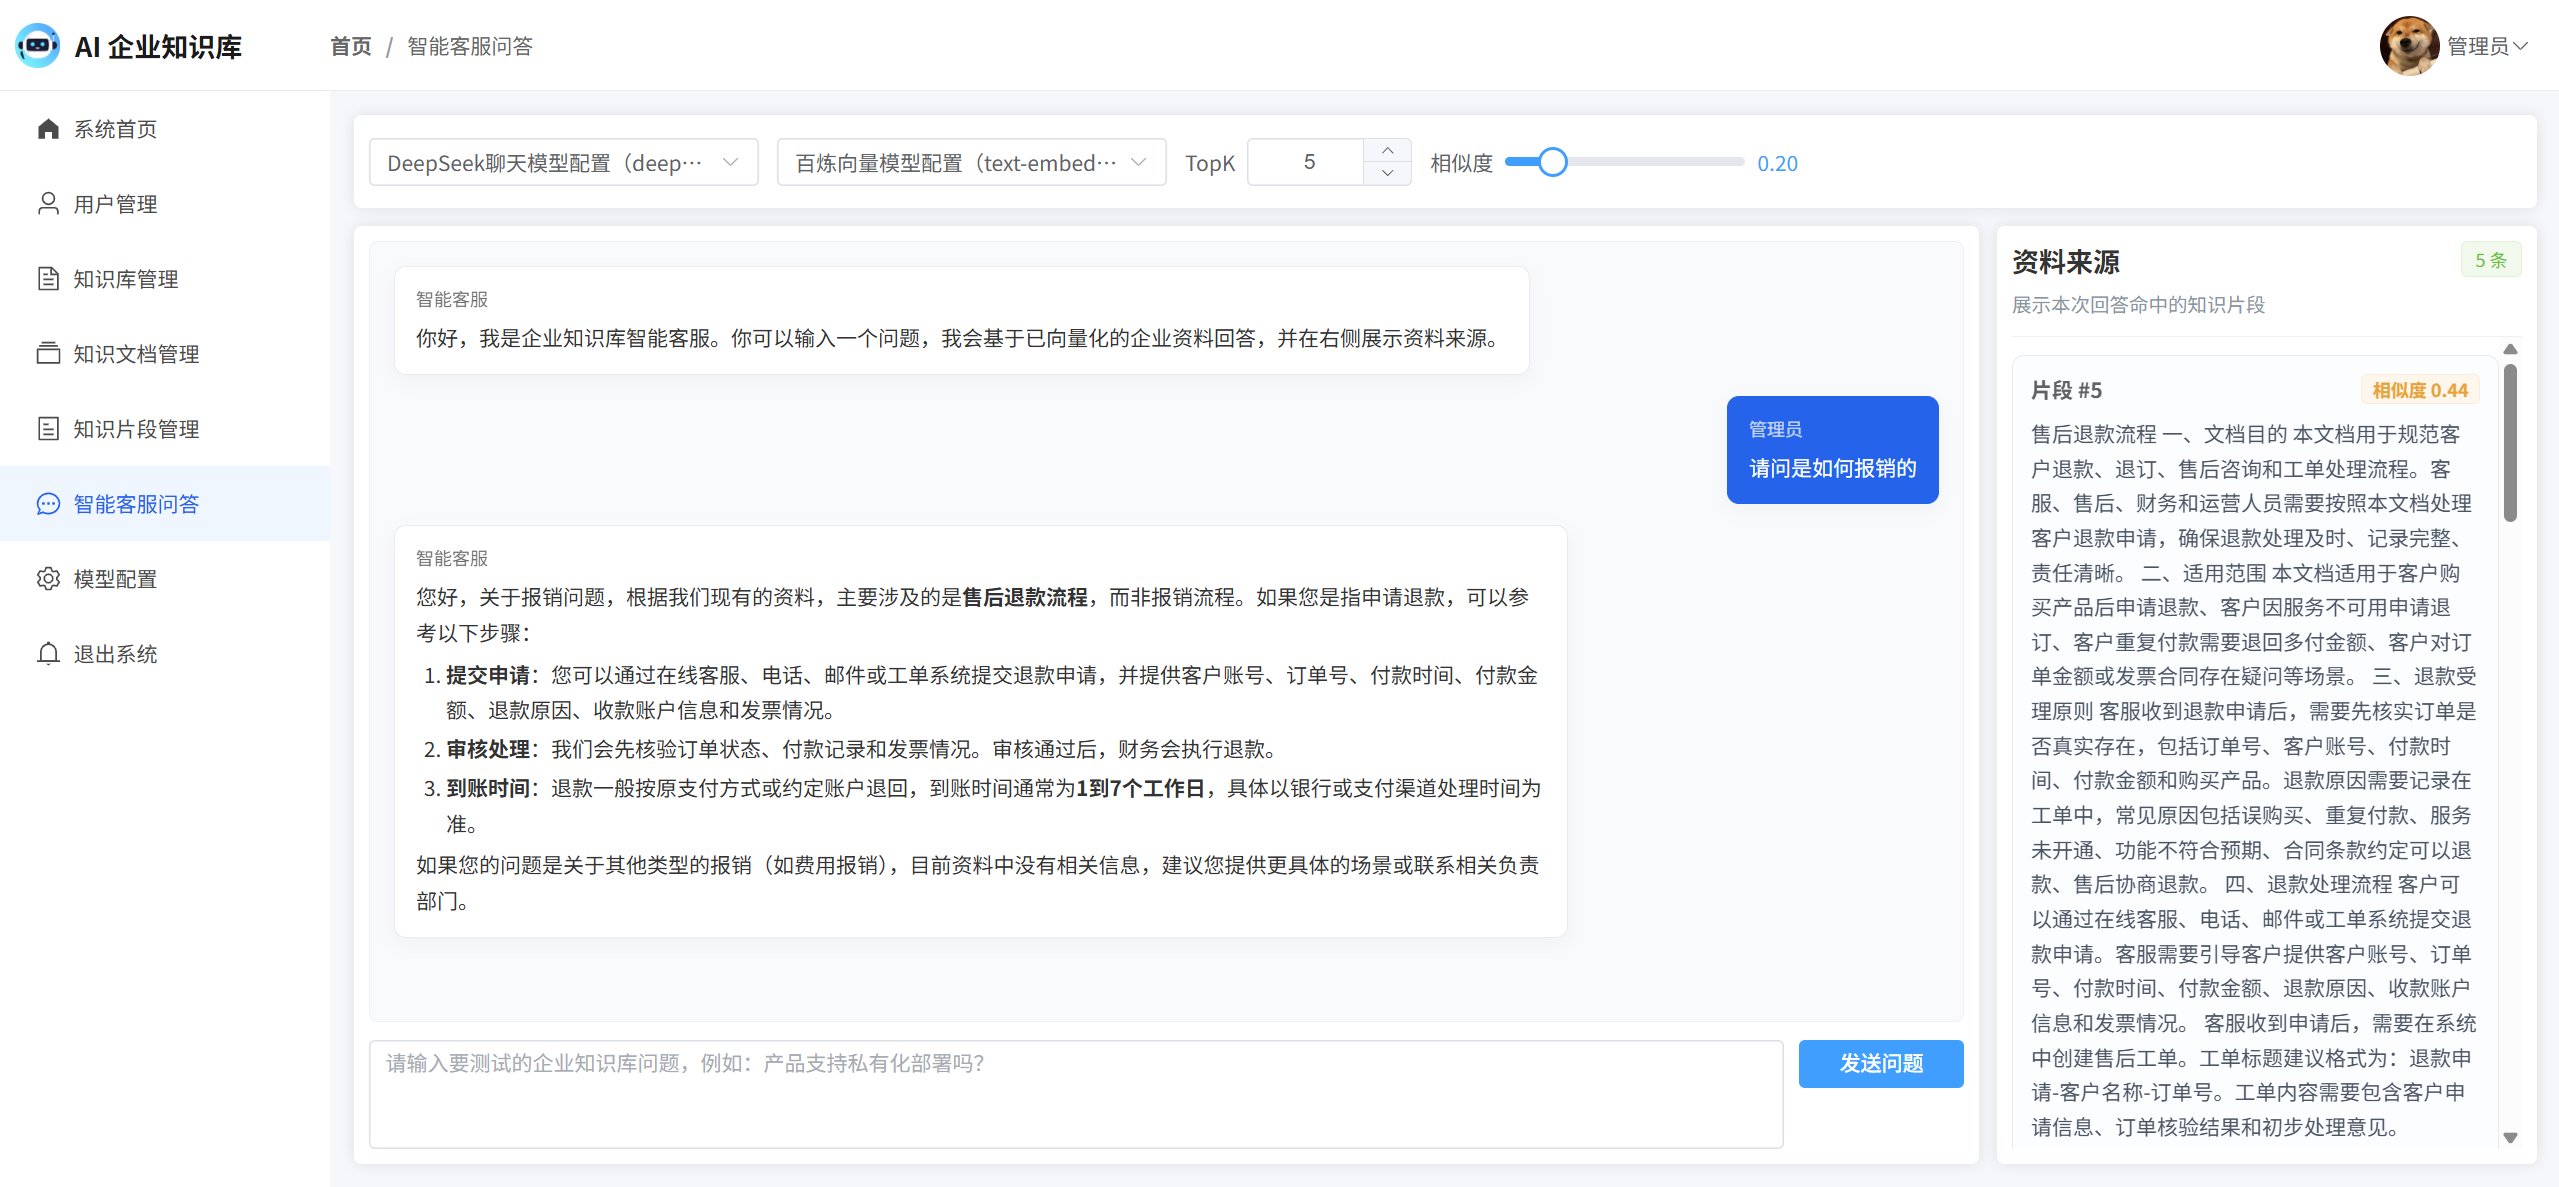
- 智能客服问答在管理端验证 RAG 问答效果,查看命中的资料来源
系统2 项
- 用户信息管理系统所有用户
- 个人资料登录、个人信息、修改密码
页面截图
共 7 张真实运行截图,点击大图查看高清原图。
 点击放大
你将获得
购买后可以拿到的全部内容。
喂饭级学习教程14 章
从工程底座讲起,到文档解析、切片、向量化、检索、问答与来源追踪,把 RAG 全链路一章一章做出来。
完整源码 + SQL
Spring Boot 后端 + Vue3 前端完整源码,MySQL 业务库与 PGVector 向量库建表脚本和初始化数据。
配套面试文档
电梯陈述、架构与选型、RAG 核心技术点深挖、高频面试题和难点包装,面试时照着讲。
环境安装文档
Windows 本地安装 PostgreSQL 与 PGVector,以及 JDK、MySQL、Node.js 等开发环境。
项目运行文档
两个数据库初始化、前后端启动、模型配置,从零把项目跑起来。
常见问题
下单前最常被问到的几个问题。
这个项目是 Java 还是 Python?
后端是 Java(JDK 21 + Spring Boot 4 + Spring AI 2),前端是 Vue3。
模型需要自己准备吗?
需要自己准备两个 API Key:DeepSeek 用于对话,阿里云百炼用于 Embedding 向量化,在管理端「模型配置」里填入即可,不用改代码。模型都走接口调用,不需要显卡。
基础薄弱能学会吗?
教程是喂饭级的,从登录注册、统一返回这些工程底座讲起,每章都有验证步骤。基础不够的话,可以先按上面的「学习路径」从基础项目学起。
能写进简历、用作毕业设计吗?
可以,配套面试文档里有项目介绍、难点包装和高频追问,照着就能讲清楚。至于毕业设计,有小伙伴问过我,统一回答一下:AI 实战库板块的项目拿去做毕业设计,就四个字——降维打击。
源码能用于商业项目吗?
源码和教程本质上是给大家学习、提升技能的。如果需要商用,自己二次开发一下也没问题,但禁止原项目 + 教程转手倒卖。我是一个程序员,能看到你们学习我的教程提升能力,能听你们叫我一声大佬,挺幸福的!知足~
售后答疑
买完不是结束跟着教程学习,遇到问题不用自己硬扛。