10分钟彻底搞懂RAG背后的工作原理
教程简介:AI实战小课堂 - RAG专题:10分钟彻底搞懂RAG背后的工作原理,一个高质量RAG背后的技术全流程。AI实战小课堂带你扫清AI技术难点。
本节内容
大家好,我是武哥。这里是 AI实战小课堂-RAG专题。
这期我们把一个高质量 RAG 企业知识库的完整流程拆开,用案例和动态图解,讲清每一步在做什么。这个10分钟的视频会带你彻底搞明白:点击查看
具体落地实战项目,大家可以学习这个AI高级实战项目:AI Agentic RAG高级企业知识库平台
RAG的核心逻辑
我们从一个知识助手说起。假设我们想给编程教程做一个知识助手,让它回答:“这个项目应该怎么配置数据库?”。答案可能就在教程的某一段里。但资料越来越多,总不能每次提问,都把所有文档发给大模型。
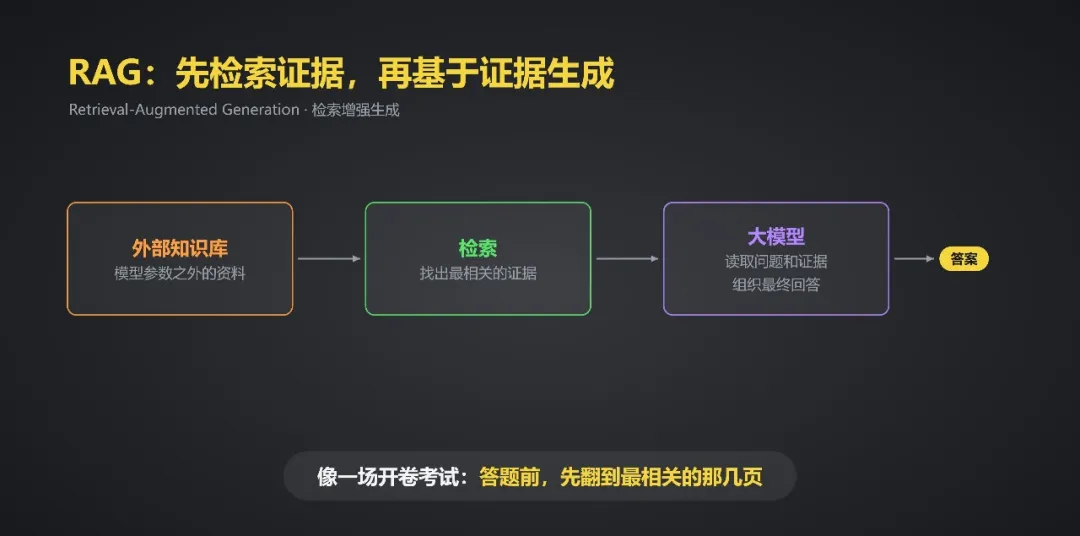
RAG 的做法是:先从资料里找到与问题相关的内容,再把这些内容交给大模型,让它据此回答。可以把它理解成开卷考试:先翻书找到依据,再组织答案。整个过程分成两部分:提问前准备好资料,提问后找资料、生成回答。
提问前:把资料变成可检索的知识库
第一步:文档切分
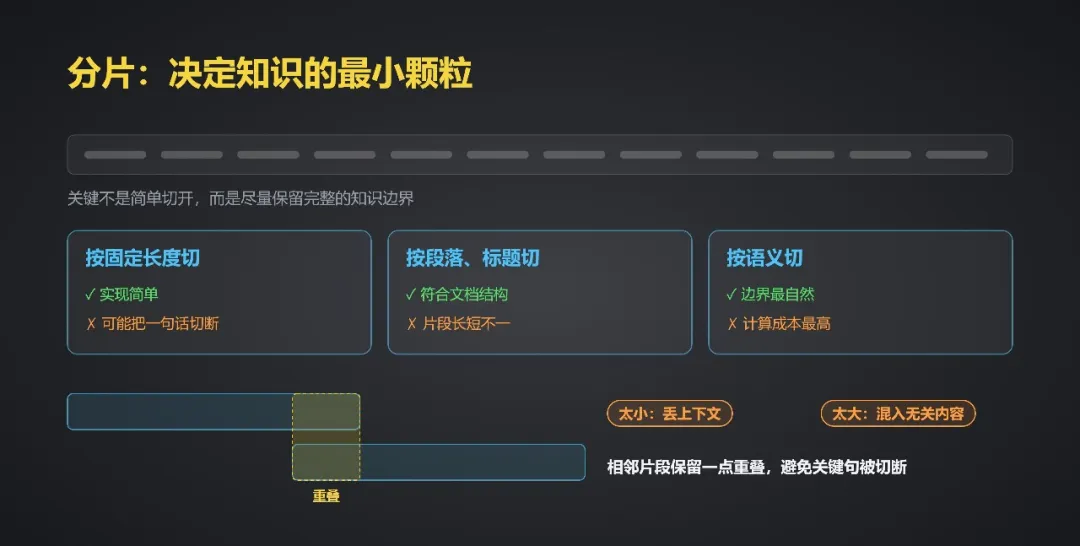
把长文档拆成多个片段,方便检索时只取出相关内容。片段不能太大,也不能太碎:太大容易夹带无关信息,太碎又可能把一句话的条件和结论拆开。
比如“满足什么条件”和“可以申请退款”,如果被拆到两个互不关联的片段里,回答就可能漏掉关键条件。
第二步:向量化
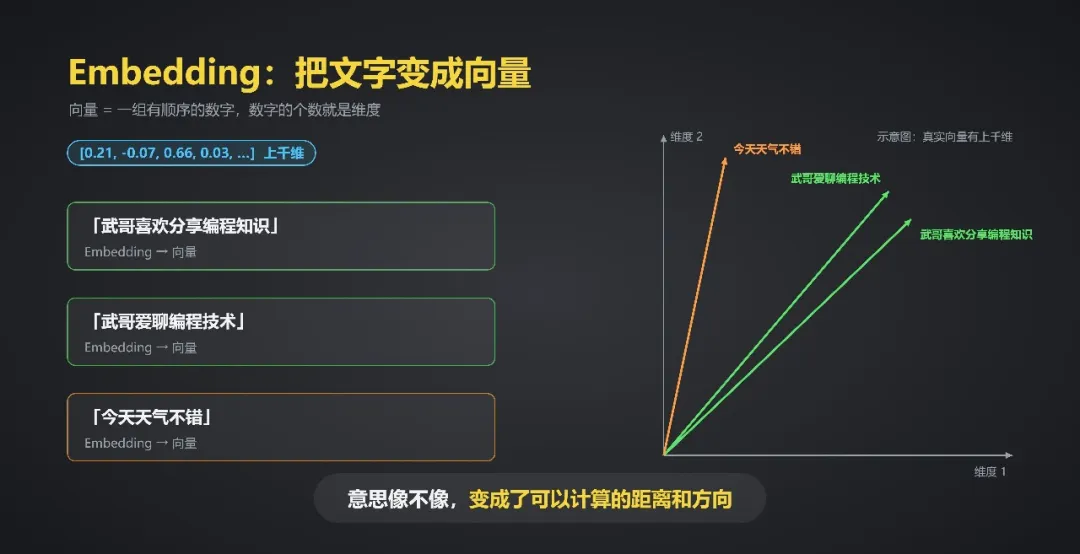
用户问“数据库连不上怎么办”,文档写的可能是“MySQL 连接失败排查”。两句话用词不同,但意思接近。
向量模型会把文字转换成一串数字。通过比较这些数字,我们可以找到意思相近的内容,而不只是匹配相同的字。
第三步:建立索引
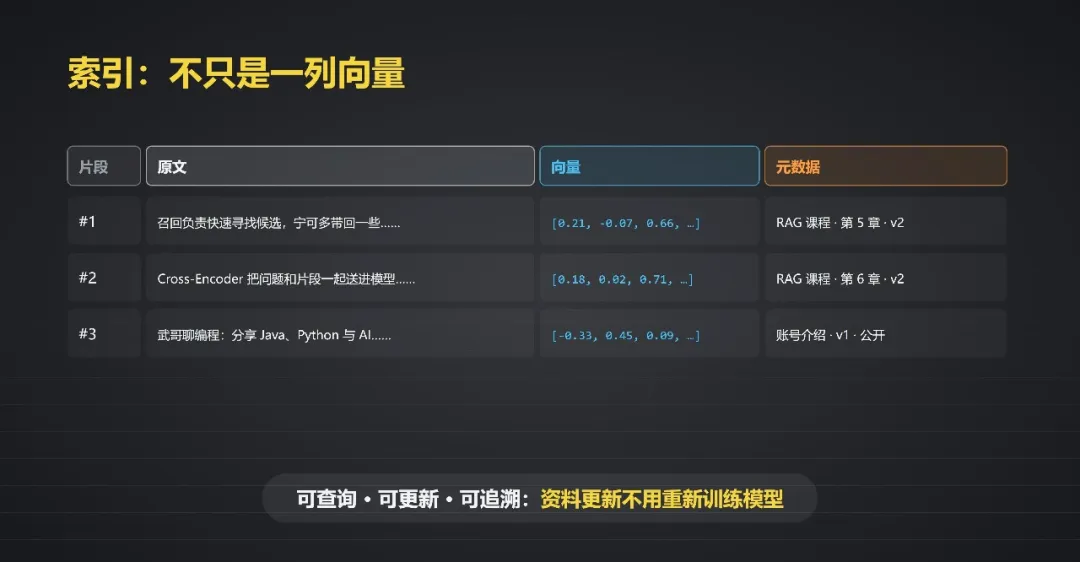
把片段、对应的向量和来源信息保存好,方便提问时快速查找。文档准备完成后,才进入问答环节。
提问后:先找到,再挑选,最后回答
用户的问题也会转换成向量,再与知识库里的片段进行比较。我们按相关程度排序,取出前几条候选内容,这就是常听到的 Top-K 召回。
不过,初步找出来的内容不一定最适合回答。比如几个片段都提到了数据库,但有的讲安装,有的讲连接配置,有的讲报错排查。
这时可以增加重排:让重排模型把问题和候选片段放在一起,进一步判断哪些内容更相关。
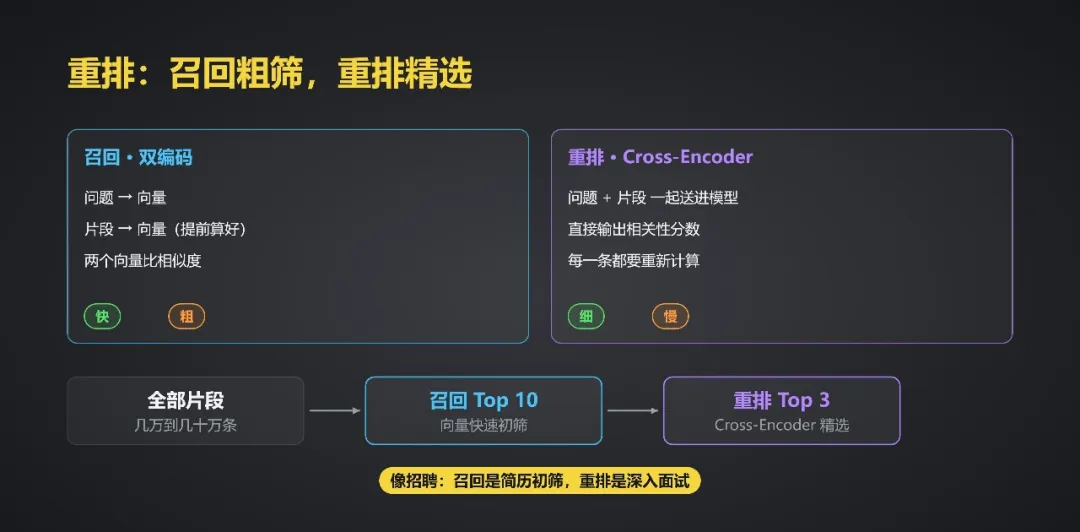
你可以把这两步理解成招聘:召回像简历初筛,先找出一批候选;重排像深入面试,再从中挑选。
最后,把用户的问题、筛选后的资料、回答规则和来源信息一起交给大模型。大模型负责理解这些内容,把答案说清楚。资料没有提供依据时,就应该明确说明,而不是自行补出一个看似合理的答案。
高质量RAG需要做好的事项
流程跑通,为什么还不够?一个知识库能回答几个演示问题,不代表它就能稳定处理真实问题。
高质量 RAG 还需要做好五件事:
- 文档质量: 资料是否准确、及时更新,用户是否有权访问。
- 分片质量: 内容边界是否完整,标题、条件和上下文是否保留。
- 检索能力: 面对不同问法,能否找到真正相关的资料。
- 上下文组装: 交给大模型的证据有没有重复、冲突或缺失。
- 评测: 用真实问题检查,既看有没有找到答案,也看回答是否忠于资料。
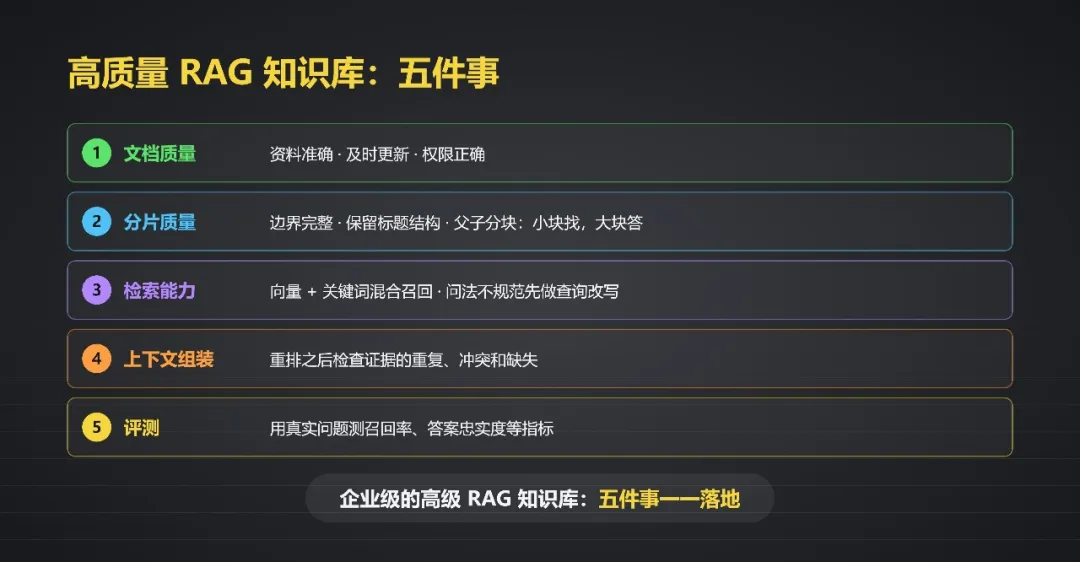
很多时候,回答不好,需要排查的是前面这些环节:资料不对、片段没切好、检索漏了内容,都会影响最终结果。
RAG的核心总结
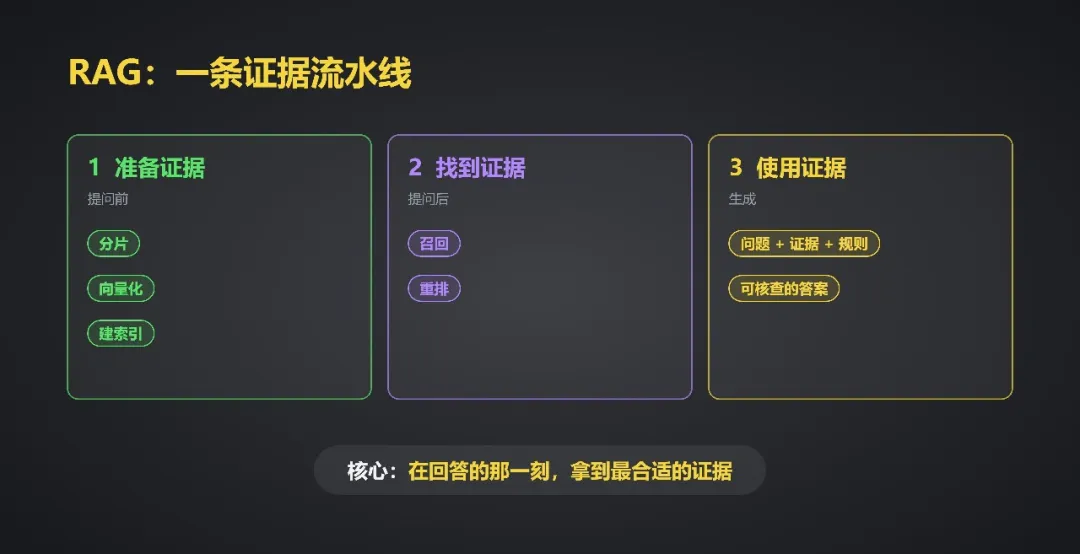
理解 RAG,可以先记住这三句话:
- 准备证据: 把资料切分、向量化,建立可检索的知识库。
- 找到证据: 根据问题召回相关片段,再筛选适合回答的内容。
- 使用证据: 把问题、资料和规则交给大模型,生成有依据、可核查的答案。
RAG 的核心,是让模型在回答的那一刻,拿到合适的资料。
视频里还会结合切分代码、相似度计算和 pgvector 查询,把这些步骤串起来。欢迎看完后,再对照这篇文章梳理一遍。
如果这期帮你弄明白了 RAG,也欢迎分享给正在学习 AI 应用开发的朋友。
这里是 AI实战小课堂,希望大家在这个板块里能学到东西!
直接学习,不需要购买
围绕一个具体主题,跟着视频快速上手。学习目标和演示内容见本节介绍,有配套笔记或资料时可按需查看。